Synthèse de voix chantée : Comment ça fonctionne et ses limites
Découvrez comment la synthèse de voix chantée transforme les paroles et les notes en audio chanté, ce que les données d'entraînement et les vocodeurs contrôlent, et où elle présente encore des lacunes.
Vous avez écrit une mélodie, adapté les paroles, et chargé un chanteur synthétique. La première écoute est encourageante, jusqu'à ce qu'un mot passe trop vite, qu'une note tenue devienne métallique, et que le refrain sonne étrangement inexpressif. Ces problèmes n'ont pas nécessairement la même cause. Comprendre où chacun d'eux intervient dans la chaîne du signal rend la correction de la voix beaucoup moins une affaire de tâtonnements.
Table des matières
- Ce qu'est la synthèse de voix chantée et d'où elle vient
- Comment un système de synthèse de voix chantée transforme une partition en son
- Pourquoi les données d'entraînement décident de la qualité d'une voix chantée
- Les modèles acoustiques et les vocodeurs déterminent la qualité
- Comment juger un système de synthèse de voix chantée
- Utilisations pratiques, limites et écarts culturels
- Confirmer les droits avant de construire ou d'acheter un modèle de chant
Qu'est-ce que la synthèse vocale chantée et son origine
La synthèse vocale chantée (SVC) génère de l'audio chanté à partir de paroles, d'une séquence de notes avec des hauteurs et des durées, et, dans de nombreux systèmes, d'une identité de chanteur sélectionnée. Imaginez que vous êtes un auteur-compositeur avec une mélodie finie mais aucun chanteur disponible. Vous entrez les notes et les mots pour entendre comment la ligne vocale s'intègre à votre arrangement.
Il ne s'agit pas seulement de synthèse vocale avec une piste d'accompagnement musicale. Une phrase parlée nécessite un phrasé crédible, mais une phrase chantée doit également suivre les hauteurs musicales, soutenir les voyelles et placer les consonnes autour du temps. Une syllabe acceptable dans une conversation peut sembler maladroite lorsqu'elle est étirée sur une longue note.
Des fragments enregistrés aux voix apprises
Les premières approches utilisaient des règles et le traitement du signal, suivies par des systèmes qui assemblaient des unités vocales enregistrées. Les approches statistiques et neuronales ont ensuite appris les relations entre les paroles, les instructions musicales et la sortie acoustique, plutôt que de se fier uniquement à l'assemblage de fragments.
Selon le récit de Yamaha sur le développement de VOCALOID, le projet a débuté en février 2000 grâce à la collaboration DAISY avec l'Universitat Pompeu Fabra de Barcelone, et le premier produit commercial est apparu en 2004. Les développeurs avaient besoin d'une base de données de chant dédiée car l'entrée informatique ordinaire et la technologie vocale conventionnelle ne pouvaient pas reproduire le chant de manière adéquate.
Des chanteurs virtuels tels que Hatsune Miku ont également contribué à transformer le chant synthétique en un médium créatif centré sur le personnage. La voix pouvait devenir une partie d'une identité artistique, et pas seulement une piste de substitution lors d'une session d'enregistrement.
Distinction utile : Générer une performance musicale et contrôler une mélodie chantée note par note ne sont pas les mêmes exigences.
Lorsque vous parcourez une liste de modèles de génération musicale, vérifiez les contrôles d'entrée plutôt que de supposer que chaque outil musical accepte une partition vocale. Pour un système de chant utilisable, vous devez comprendre sa chaîne de signal, reconnaître ses limites de qualité et établir comment ses voix peuvent être évaluées et sous licence.
Comment un système de synthèse vocale chantée transforme une partition en son
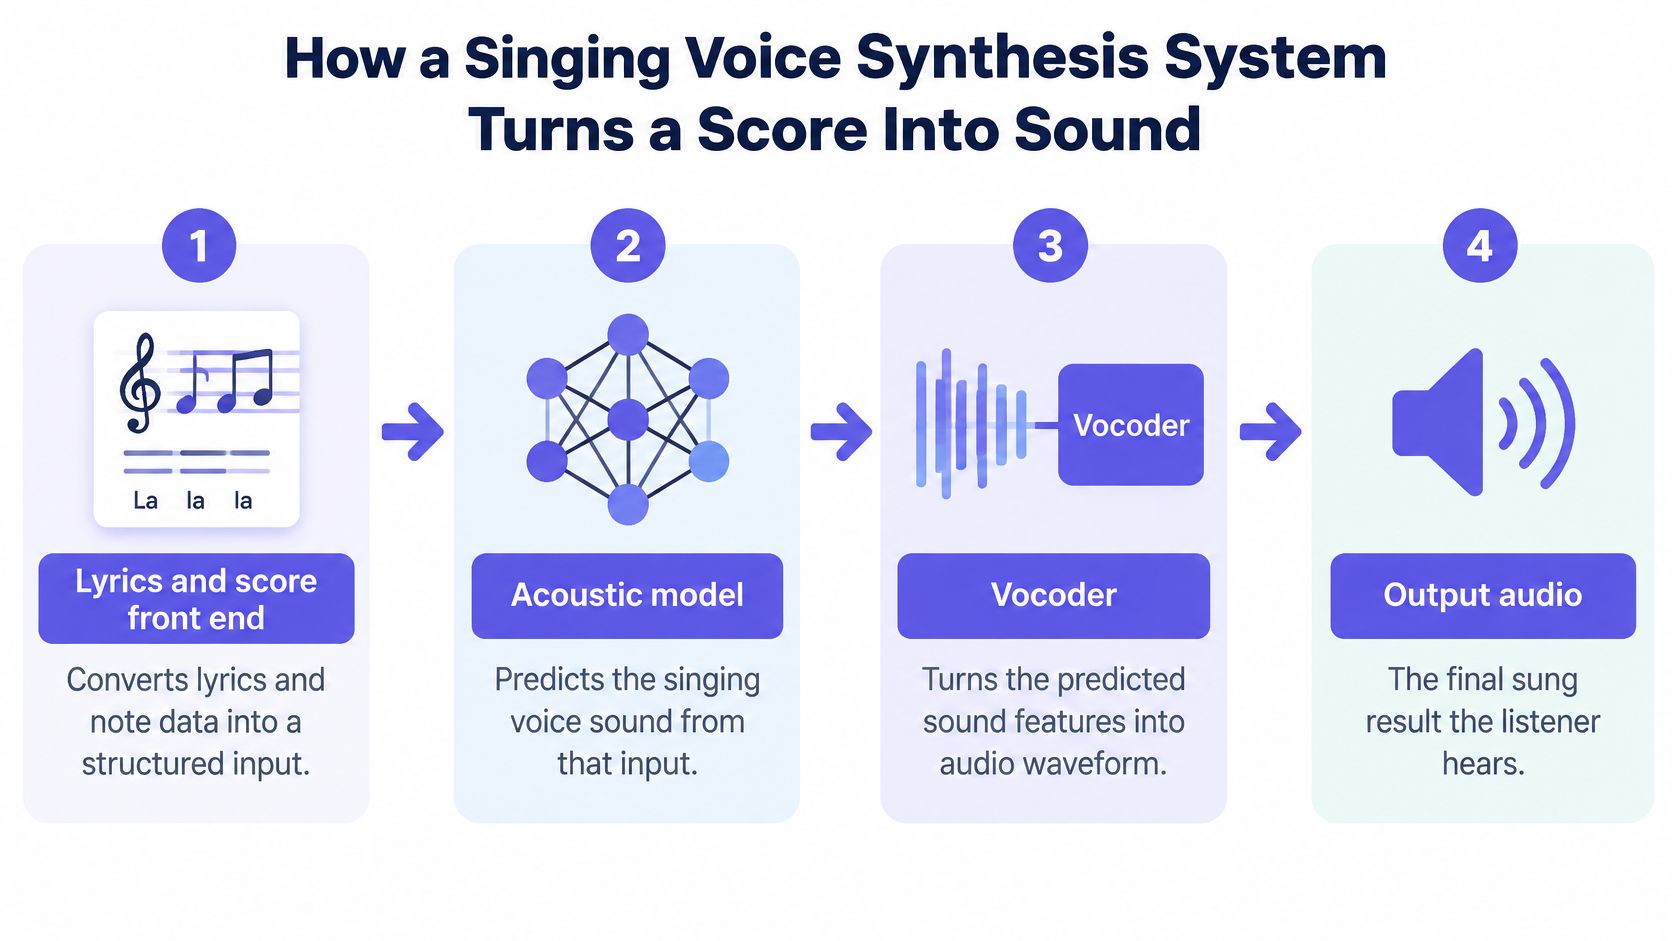
Qu'est-ce qui entre, et qu'est-ce qui sort ? Dans un flux de travail contrôlé par partition, l'entrée est un ensemble d'instructions musicales. La sortie est une forme d'onde que vous pouvez lire, éditer et mixer.
Étapes du pipeline dans un système de synthèse vocale chantée
| Étape | Entrée | Sortie | Ce qu'elle contrôle |
|---|---|---|---|
| Front-end paroles et partition | Paroles, hauteur de note et durée de note | Séquence de phonèmes avec timing | Quel son est chanté sur quel temps |
| Modèle de durée et de hauteur | Phonèmes et partition | Timing au niveau de la trame et courbe de hauteur | Vibrato, attaques de notes et précision de la hauteur |
| Modèle acoustique | Phonèmes, timing, hauteur et identité du chanteur | Mel-spectrogram | Timbre, forme des voyelles et articulation |
| Vocodeur | Mel-spectrogram | Forme d'onde audio | Clarté, souffle et artefacts audibles |
L'illustration montre le flux général, avec les décisions de durée et de hauteur incorporées dans le processus de prédiction.
Transformer les mots et les notes en une performance
Le front-end décompose les paroles en phonèmes, les sons de parole individuels au sein des mots, et les associe aux notes. Une syllabe écrite n'est pas un son unique ininterrompu. Dans stay, les consonnes d'ouverture nécessitent un traitement différent de la voyelle qui porte la hauteur soutenue.
Si le système alloue trop de temps aux consonnes, la voyelle peut arriver en retard. S'il raccourcit la voyelle pour compenser, le mot semble précipité même si la note se termine à temps. Commencez par la prononciation et le placement des phonèmes lorsqu'une parole semble rythmiquement incorrecte.
Le modèle de durée et de hauteur décide comment ces sons se déploient dans le temps. La note spécifie une hauteur cible, mais la courbe de hauteur exécutée peut inclure une approche douce, un centre stable et un vibrato vers la fin. Une courbe parfaitement plate peut sembler rigide ; une transition exagérée peut ressembler à un glissando involontaire.
Certains outils acceptent des données de note explicites, tandis que d'autres génèrent ou infèrent une mélodie à partir d'entrées moins contraintes, y compris les paroles. Cette différence détermine si vous pouvez réparer une note particulière directement ou si vous devez demander une autre performance.
Transformer une description de performance en audio
Le modèle acoustique prédit une représentation telle qu'un mel-spectrogram, qui décrit comment l'énergie sonore est distribuée en fonction de la fréquence au fil du temps. Pensez-y comme une carte changeante du timbre de la voix, pas un fichier audio que vous pouvez déjà entendre.
Des caractéristiques spectrales mal définies peuvent produire des voyelles ternes, des consonnes floues ou une identité vocale instable. Mais la seule ternissure ne prouve pas que le modèle acoustique est responsable. Le générateur de forme d'onde final peut également masquer des détails utiles.
Le vocodeur convertit la représentation prédite en échantillons sonores. Des bourdonnements, un grain ou des textures métalliques peuvent provenir d'ici, en particulier sur les voyelles soutenues exposées.
Avant d'éditer, identifiez si l'outil accepte les notes et quels contrôles affectent l'étape suspectée. N'essayez pas de corriger une consonne mal placée avec l'égalisation, ou une forme d'onde rugueuse en réécrivant une parole correctement prononcée.
Pourquoi les données d'entraînement déterminent la qualité d'une voix chantée
L'enregistrement du chant n'est qu'une partie de la construction d'un ensemble de données utile. Les développeurs ont également besoin de paroles fiables, d'un alignement des notes, d'un timing des phonèmes et d'annotations qui distinguent l'expression intentionnelle des erreurs. Sans ce contexte, un modèle peut apprendre un événement acoustique sans apprendre quand il doit être utilisé.
La comparaison des corpus dans l'enquête sur les ensembles de données de chant illustre l'échelle limitée et la couverture des chanteurs de plusieurs ressources influentes, résumées ci-dessous.
Ensembles de données de chant par taille et couverture
| Corpus | Chanteurs | Heures | Ce qu'il couvre |
|---|---|---|---|
| VocalSet | 20 | Environ 10.1 | Techniques vocales, voyelles et hauteurs variées, pas des chansons complètes |
| NUS-48E | 12 | Environ 2.8 | Petit corpus avec un nombre limité de chanteurs |
| MIR-1K | 19 | Environ 2.2 | Petit corpus avec un nombre limité de chanteurs |
| CSD | 1 | Environ 4.9 | 100 chansons en deux langues d'un seul chanteur |
| SingNet | Non spécifié dans le résumé cité | Environ 3,000 | Chant "in-the-wild" et packs d'échantillons dans différentes langues et styles |
Le prépublication SingNet rapporte 2,629 heures de chant "in-the-wild" et 321 heures provenant de packs d'échantillons, totalisant environ 3,000 heures. Cela représente une expansion substantielle du matériel disponible, mais la taille de la collection n'est pas un certificat de couverture musicale.
La couverture compte autant que la durée
L'accent mis par VocalSet sur les techniques, les voyelles et les hauteurs le rend utile pour l'étude du comportement vocal. Cela ne le rend pas interchangeable avec un corpus de chansons complètes, phrasées de manière expressive. De même, une collection d'un seul chanteur peut offrir une cohérence sans démontrer qu'un système se généralisera à travers différentes identités vocales.
Le surapprentissage signifie qu'un modèle devient trop dépendant des motifs de son matériel d'entraînement. En écoute pratique, cela pourrait signifier une voyelle familière convaincante mais une prononciation inconnue maladroite, ou un résultat solide dans un style représenté et un résultat peu convaincant ailleurs.
Pour la sélection du modèle, examinez :
- Couverture des chanteurs : Recherchez des tessitures vocales et des identités documentées, pas seulement une durée totale d'enregistrement.
- Couverture linguistique : Vérifiez si votre langue de paroles et vos conventions de prononciation sont représentées.
- Couverture musicale : Distinguez les exercices isolés des phrases complètes, des transitions et de l'expression soutenue.
- Qualité de l'annotation : Recherchez une explication de la manière dont les paroles et les notes ont été alignées avec les enregistrements.
La question utile n'est pas seulement la quantité d'audio qu'un développeur a collectée. C'est à quel point le matériel documenté correspond à la performance dont vous avez besoin. Une documentation manquante limite la confiance avec laquelle vous pouvez appliquer une affirmation de qualité au-delà d'une démonstration soignée.
Les modèles acoustiques et les vocodeurs décident où la qualité se gagne
Le générateur de forme d'onde peut modifier de manière significative la qualité de chant perçue, même lorsque le prédicteur en amont reste identique. Cela fait du vocodeur un choix d'ingénierie, et pas seulement une étape d'exportation.
Dans une étude contrôlée sur la synthèse vocale neuronale de chant, les modèles acoustiques basés sur les CNN ont surpassé les réseaux feed-forward correspondants lors des tests de naturel, et le remplacement du vocodeur MLSA traditionnel par WaveNet a amélioré les deux familles de modèles. L'étude a été entraînée sur 55 chansons japonaises pour enfants et 55 chansons J-pop, a mis de côté cinq chansons J-pop, et a utilisé des scores d'opinion moyens sur cinq points de 15 auditeurs évaluant des phrases de test sélectionnées au hasard. Ces résultats soutiennent une comparaison contrôlée, et non un classement universel entre chanteurs, langues ou genres.
Séparer les erreurs de prédiction des erreurs de rendu
Un modèle acoustique peut prédire une structure vocale erronée. Un vocodeur peut mal rendre une prédiction raisonnable. Les deux types d'échecs peuvent sembler artificiels, mais le remplacement du même composant ne résoudra pas les deux.
Pour un système modulaire, testez le vocodeur en utilisant des caractéristiques acoustiques extraites d'un enregistrement de référence propre. Il s'agit d'un test de resynthèse : vous vérifiez la qualité avec laquelle l'étape de forme d'onde reconstitue des informations qui existent déjà, plutôt que de demander au prédicteur acoustique de les inventer.
Ensuite, synthétisez à partir de la partition. Si la resynthèse de référence est claire mais que la sortie générée par la partition est brouillonne, examinez les caractéristiques prédites, l'alignement et le conditionnement de la hauteur tonale. Si la reconstruction de référence semble déjà granuleuse, abordez d'abord le vocodeur ou la compatibilité des caractéristiques.
Ne remplacez pas l'ensemble du modèle avant d'avoir vérifié si le défaut existe avant la génération de la forme d'onde.
Cette distinction est également importante lors de l'évaluation des outils vocaux adjacents. Une liste de modèles de synthèse vocale décrit une tâche différente ; une sortie vocale intelligible seule n'établit pas la qualité des notes tenues ou le contrôle de la partition.
Choisissez la fidélité et la latence adaptées à la tâche réelle
Les vocodeurs autorégressifs de type WaveNet génèrent l'audio séquentiellement, ce qui peut augmenter la latence. Des alternatives plus rapides, y compris LPCNet, peuvent être plus appropriées lorsque la réactivité de la lecture est importante.
Pour le rendu hors ligne, vous pouvez accepter un temps d'attente plus long pour préserver les détails vocaux. Pour la composition interactive, vous pouvez préférer un aperçu rapide et réserver un rendu de meilleure qualité pour la révision.
Mesurez à la fois le temps de génération et les artefacts que vous pouvez entendre dans le cadre de votre flux de travail prévu. Un beau rendu isolé est moins utile s'il interrompt chaque petite modification de mélodie, tandis qu'un aperçu réactif ne doit pas être confondu avec la meilleure sortie finale que le système peut produire.
Comment juger un système de synthèse vocale chantée
Une voix peut sembler naturelle tout en étant fausse, ou suivre les notes avec précision tout en paraissant faible. Aucun score de qualité unique ne décrit l'ensemble de la performance. Vous avez besoin de jugements d'auditeurs en plus des mesures du signal généré.
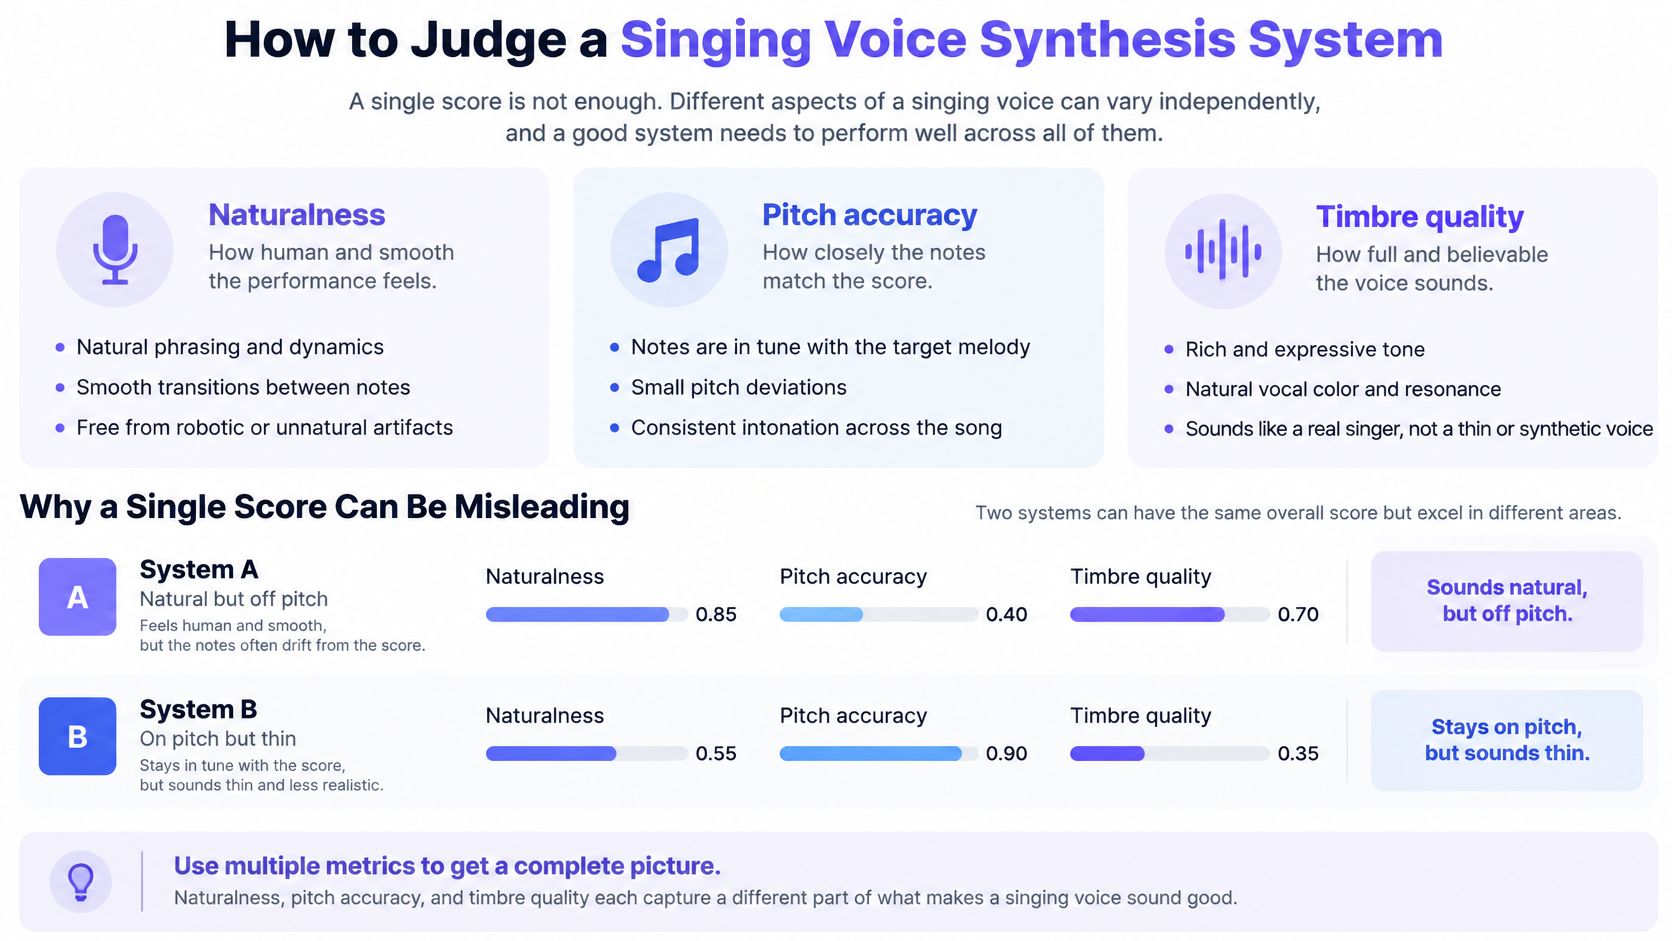
Le papier WeSinger 2 utilise le MOS, l'erreur quadratique moyenne F0 et la distorsion du mel-spectrogramme pour examiner les aspects complémentaires de la qualité du chant. Son entraînement contradictoire conditionnel multi-chanteurs améliore le MOS par rapport au système WeSinger précédent sur Opencpop et Data-L, mais les gains comparatifs diffèrent selon les ensembles de données, soulignant l'importance des conditions du chanteur et du corpus.
Métriques pour juger la qualité de la synthèse vocale chantée
| Métrique | Ce qu'elle mesure | Ce qu'elle ne mesure pas |
|---|---|---|
| MOS | Qualité perçue globale par les auditeurs | Peut masquer les dérives de hauteur et les détails spécifiques au chanteur |
| F0 RMSE | Erreur de hauteur, d'intonation et d'accordage | Souffle, prononciation et timbre |
| MSD | Désaccord spectral lié au timbre et à l'articulation | Si une phrase semble expressive ou conforme au style |
Lisez les mesures ensemble
Le MOS, ou score d'opinion moyen, résume les évaluations des auditeurs. Il est utile pour savoir si les gens préfèrent le résultat global, mais l'interprétation dépend de ce qu'ils ont entendu et de ce qu'on leur a demandé de juger.
Le F0 RMSE mesure l'erreur de fréquence fondamentale, la quantité acoustique associée à la hauteur perçue. Il aide à révéler les problèmes d'accordage, mais il n'établit pas que les mots sont intelligibles ou que le ton vocal est crédible.
Le MSD compare les représentations spectrales. Il peut exposer des différences liées à l'articulation et au timbre, mais faire correspondre un spectrogramme de référence n'est pas la même chose que de faire un choix artistique convaincant.
Vérification à l'écoute : Auditionnez la voix seule avant de la juger au sein d'un mix dense. L'accompagnement peut rendre les consonnes faibles et les fins de notes instables plus difficiles à remarquer.
Constituez un ensemble d'évaluation contenant des chansons inconnues et, lorsque le système les prend en charge, des chanteurs non vus. Incluez des voyelles tenues, des paroles riches en consonnes, des changements de registre et des phrases qui nécessitent un timing expressif délibéré.
Rapportez les métriques ensemble, puis écoutez spécifiquement le souffle, la prononciation et l'identité vocale. Si un fournisseur n'offre qu'un score de naturalité global, considérez-le comme une preuve concernant ce test d'écoute, et non comme la preuve que vos paroles, votre chanteur et votre arrangement fonctionneront aussi bien.
Usages pratiques, limites et écarts culturels
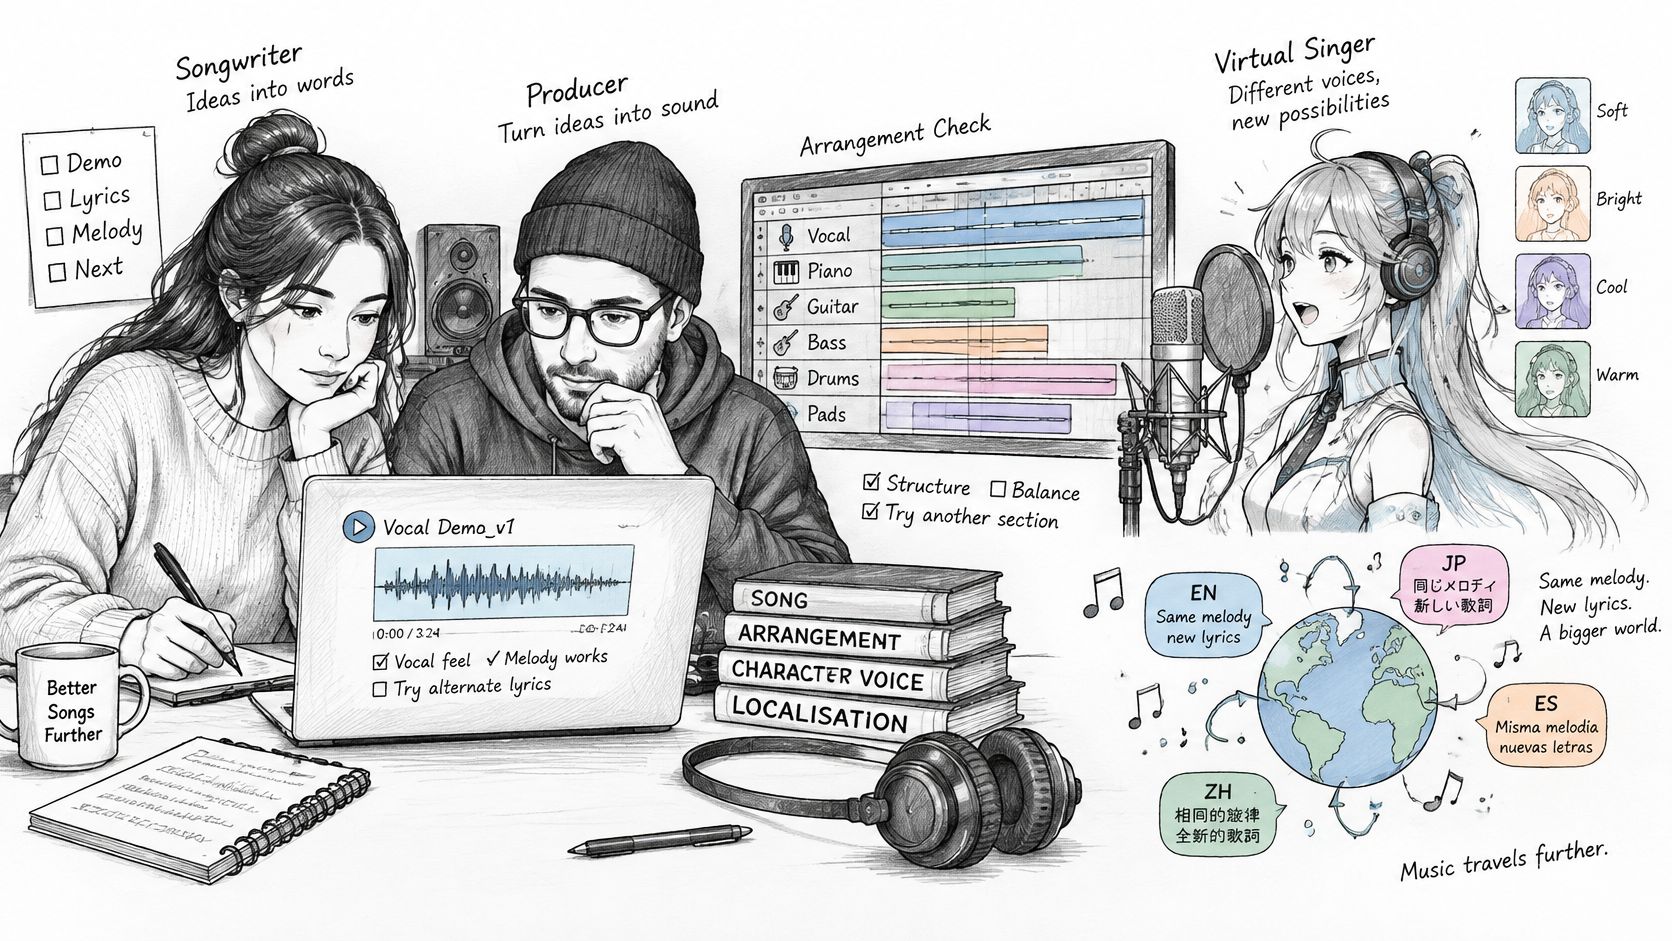
Un auteur-compositeur peut utiliser le chant synthétique pour vérifier si un refrain est chantable avant d'organiser une session. Un producteur peut auditionner une harmonie, tandis qu'une équipe de jeu peut tester comment la chanson d'un personnage s'intègre à une scène. Ce sont des usages pratiques car la performance générée aide les gens à prendre une décision de production concrète.
Les sorties centrées sur les personnages et les prototypes d'animation peuvent également utiliser une esthétique vocale délibérément synthétique. Pour le prototypage audiovisuel, un guide pour créer un clip musical d'IA peut aider à connecter le flux de travail audio à la production visuelle, mais la voix a toujours besoin de sa propre révision musicale.
Tester l'expression, pas seulement les notes justes
La localisation est un exemple utile où une tâche apparemment simple devient exigeante. Garder la mélodie tout en changeant de langue signifie adapter de nouvelles syllabes, des schémas d'accentuation et des consonnes à une phrase existante. Une traduction littérale peut être inappropriée comme parole chantée.
L'expression culturellement spécifique ajoute une autre couche. Le chapitre sur le chant classique indien décrit l'ornementation en relation avec la note particulière, le raga, le chanteur et le contexte musical, des détails que les mesures conventionnelles de hauteur et d'intelligibilité peuvent manquer.
Utilisez des tests ciblés plutôt que de simplement demander si le résultat semble humain :
- Ornementation : Demandez à un musicien familier avec la tradition de juger le mouvement entre et autour des notes.
- Alternance codique : Placez un changement de langue à l'intérieur d'une phrase et vérifiez l'accent, l'emphase et la continuité de l'identité vocale.
- Mots rares : Testez les noms et le vocabulaire lyrique peu familier, puis demandez à un locuteur courant d'évaluer la prononciation.
- Phasé : Comparez où le chanteur généré respire, met l'accent sur un mot ou relâche une fin soutenue.
Vérifier l'origine séparément de la qualité
Une voix convaincante n'établit pas qui l'a interprétée. Le compte rendu du National Institute of Justice sur le premier défi de détection de deepfake de voix chantée rapporte 47 équipes participantes et un taux d'erreur égal de 1.65% pour l'équipe la mieux classée dans le cadre du défi.
Ce résultat démontre la performance mesurée d'un détecteur dans des conditions particulières, et non une authentification garantie d'une publication arbitraire. Traitez la détection comme une vérification parmi d'autres, à côté des enregistrements de provenance, des fichiers source et de l'autorisation documentée.
Le chant synthétique est particulièrement utile pour les brouillons, les prototypes et les voix de personnages intentionnelles. Une voix commerciale finale, surtout pour une sortie majeure, nécessite une révision humaine pour l'expression musicale, la précision linguistique, l'identité et la provenance, plutôt qu'une approbation basée uniquement sur une démo au son clair.
Confirmez les droits avant de créer ou d'acheter un modèle de chant
Qui a autorisé la voix avant qu'elle ne soit entraînée, clonée ou diffusée ? Un enregistrement vocal peut impliquer un interprète, un propriétaire d'enregistrement, un parolier et un compositeur. L'autorisation concernant une contribution ne règle pas automatiquement les autres.
L'article d'AI & Society sur la gouvernance des données de chant avertit qu'une licence Creative Commons standard pourrait ne pas protéger adéquatement les contributeurs de données de chant, car les enregistrements peuvent contenir à la fois la voix d'un interprète et une chanson protégée par le droit d'auteur. Il distingue également les règles d'utilisation équitable (fair-use) des États-Unis de l'exception de fouille de textes et de données (text-and-data-mining) de l'UE, plutôt que de les traiter comme des autorisations interchangeables.
Mettez les utilisations autorisées par écrit
Utilisez une liste de contrôle des droits avant de transférer des enregistrements ou d'intégrer un modèle :
- Identifiez les droits pertinents. Documentez les autorisations concernant les enregistrements du chanteur, les paroles, la composition, l'image et la diffusion commerciale prévue. Enregistrez qui peut autoriser chaque utilisation plutôt que de supposer que la personne fournissant le fichier contrôle tout.
- Spécifiez les activités du modèle. Indiquez si l'accord autorise l'entraînement, le fine-tuning, le clonage vocal, la redistribution et l'utilisation commerciale en aval. Une licence pour publier une piste audio ne devrait pas devenir une autorisation de construire un modèle vocal réutilisable.
- Lisez les termes de la licence. Ne vous fiez pas uniquement à une étiquette Creative Commons. Vérifiez si les termes abordent la contribution de l'interprète et la chanson sous-jacente.
- Vérifiez la juridiction applicable. Demandez à un conseiller juridique qualifié d'évaluer les règles pertinentes pour les enregistrements, les contributeurs et le déploiement. Ne transposez pas une exception d'un autre système juridique dans votre accord.
- Planifiez ce qui se passe après l'entraînement. Définissez les procédures de révocation, la suppression du modèle, l'attribution et le partage des revenus. Spécifiez qui gère les demandes et quels recours sont techniquement et contractuellement disponibles.
Conservez les preuves avec les actifs de production
Maintenez un registre des autorisations à côté de l'ensemble de données ou du projet. Incluez la version de l'accord, les utilisations autorisées, les identifiants d'enregistrement source et toute restriction de distribution. Cela facilite la distinction entre une entrée autorisée et un fichier qui est simplement arrivé dans un dossier partagé.
La disponibilité publique n'est pas une preuve de consentement ou de propriété. De même, une promesse de supprimer un enregistrement ne doit pas être confondue avec une capacité démontrée à supprimer son influence d'un modèle déjà entraîné.
Avant de créer ou d'acheter un modèle de chant, obtenez des conditions écrites couvrant chaque droit pertinent, activité autorisée et obligation post-entraînement.
MartLLM est une API pour les modèles de texte, d'image, de vidéo, de musique et de parole. Si vous construisez un flux de travail de production lié au chant, visitez MartLLM pour explorer les listes de modèles et comparer leurs entrées documentées avec vos exigences en matière de contrôle de partition, de sortie audio et de tâches multimédias environnantes.