Hoe kies en integreer je een Image Generation API
Vergelijk Image Generation API-mogelijkheden, aanvraagvelden, asynchrone resultaten, modeltests, foutafhandeling en facturering, met stappen voor productie-integratie.
Meer dan 15 miljard afbeeldingen waren gecreëerd met tekst-naar-afbeelding-algoritmes tegen augustus 2023,, gemiddeld ongeveer 34 miljoen per dag sinds DALL-E 2 werd gelanceerd, volgens een Everypixel-analyse van AI-afbeeldingsstatistieken. Dezelfde analyse schrijft ongeveer 12.6 miljard daarvan, ruwweg 80%, toe aan op Stable Diffusion gebaseerde modellen, diensten en applicaties.
Bij dat volume houdt het genereren van afbeeldingen op een creatieve demo te zijn en wordt het infrastructuur. De vragen die bepalen of een product wordt uitgebracht, gaan niet langer over welk model mooiere plaatjes schildert, maar beginnen te gaan over request contracts, job states, timeout behavior, en of een mislukte generatie nog steeds op je factuur terechtkomt.
Dit is een gids voor bouwers voor de image generation API-laag. Het behandelt hoe requests worden gevormd, hoe taken door een lifecycle bewegen, hoe je een model test in plaats van een leaderboard te vertrouwen, en waar kosten zich verbergen. Prijs per afbeelding is het gemakkelijkste getal om te vergelijken en het minst nuttige op zichzelf.
Inhoudsopgave
- Mogelijkheden van de Afbeeldingsgeneratie API in één oogopslag
- Aanvraagpatronen en Antwoordvelden
- Asynchrone taken, Taakstatussen en Resultaatophaling
- Criteria voor Modelselectie en Hoe deze te testen
- Bewerkingsgetrouwheid en Herkomst controleren vóór de lancering
- Latentie, Fouten en Herhaalpoginggedrag in Productie
- Hoe een Afbeeldings-API stap voor stap te integreren
- Factureringseenheden en Hoe Echte Kosten te Vergelijken
- Voer een Testoproep uit voordat u uw Model kiest
Mogelijkheden van de Image Generation API in één oogopslag
| Mogelijkheid | Invoer | Uitvoer | Ophaalpatroon |
|---|---|---|---|
| Tekstgeneratie | berichten en parameters | gestreamde tekst | streaming respons |
| Tekst naar afbeelding | prompt, grootte, model-ID | één of meer afbeeldingen | taak, gepeild of webhook |
| Afbeelding bewerken | bronafbeelding, instructie, optioneel masker indien ondersteund | bewerkte afbeelding | taak, gepeild of webhook |
| Tekst naar video | prompt, duur, resolutie | videobestand | taak, gepeild of webhook |
| Afbeelding naar video | bronafbeelding, prompt, duur | videobestand | taak, gepeild of webhook |
| Muziekgeneratie | prompt, stijl, duur | audiobestand | taak, gepeild of webhook |
| Spraaksynthese | tekst, stem | audiobestand | gestreamde audio of een geretourneerd bestand |
Eén endpoint en één key kunnen meerdere modelfamilies tegelijk bestrijken, omdat de model-ID de familie en de versie selecteert. Dit gemak heeft echter een keerzijde. Elke familie accepteert een andere set parameters, dus een body die voor het ene model valideert, kan voor een ander model mislukken, en groottes, maskers, seed-ondersteuning en multi-output limieten verschillen allemaal tussen de modellen.
Een image generation API is een gehoste inferentiedienst met drie onderdelen: een request contract dat een prompt en instellingen omzet in een ondertekende aanroep, een result object dat de afbeelding plus de metadata ervan bevat, en een job lifecycle voor werk dat langer duurt dan één HTTP-respons. Elk onderdeel vereist zijn eigen ontwerpbeslissingen, en elk faalt op een andere manier.
Het patroon is jonger dan het lijkt. De publieke release van Stable Diffusion op 22 augustus 2022 vestigde de serving shape die de meeste providers nog steeds gebruiken, zoals TechCrunch rapporteerde bij de lancering: een applicatie plaatst een prompt en parameters, de provider voert het GPU-werk uit, en een afbeelding of een taak komt terug. Dat model draaide op high-end consumentenhardware en produceerde 512×512-pixel afbeeldingen in een paar seconden, getraind op LAION-5B, een dataset van ruwweg 5.85 miljard afbeelding-tekstparen met een esthetisch gefilterde subset van ongeveer 600 miljoen. Stability AI beweerde dat meer dan 15,000 testers ongeveer 2 miljoen afbeeldingen per dag genereerden tijdens de vroege publieke toegang, wat het duidelijkste vroege signaal is dat gehoste toegang, en niet desktopsoftware, de vorm van de vraag was.
De volgende secties volgen de volgorde waarin een echte integratie deze problemen tegenkomt: eerst request fields en response objects, dan async task states, model selectie tests, bewerkingsgetrouwheid en herkomst, latency en retries, stap-voor-stap integratie, billing units, en een laatste testoproep. Teams die generaties in een geautomatiseerde pipeline integreren, willen meestal de hele loop één keer gedemonstreerd zien, en deze walkthrough van een image API voor automatiseringsworkflows toont de volledige cyclus van trigger tot opgeslagen asset.
Verzoekpatronen en Antwoordvelden
De meeste eerste integraties falen in de request body, en zelden door de prompt. Bouw de velden in de volgorde waarin ze over de lijn gaan en het debuggen wordt korter.
- Model-ID. Stuur het als eerste in je eigen overweging, want het bepaalt welke van de overige velden geldig zijn. Een negatieve prompt of een masker dat het ene model accepteert, wordt door het volgende afgewezen.
- Prompt en negatieve prompt. De negatieve prompt is een ondersteund veld bij sommige families en wordt bij andere genegeerd, dus verifieer in plaats van aan te nemen.
- Grootte of beeldverhouding. Druk het uit zoals het model verwacht, in pixels of in benoemde verhoudingen. Valideer het lokaal vóór inference, want een afgewezen aanroep kost een round trip terwijl een generatie die laat faalt een timeout en een wachtrijslot kost.
- Aantal outputs. Meerdere outputs per aanroep lijken efficiënt totdat je merkt dat de facturering meestal schaalt met het aantal, niet met de aanroep.
- Outputformaat. PNG, JPEG of WebP verandert je downstream conversiewerk net zoveel als je byteaantal.
- Seed. Voeg het toe wanneer reproduceerbaarheid belangrijk is. Zonder, betekent "voer dat opnieuw uit" "gooi de dobbelstenen opnieuw."
- Webhook URL. Lange taken eindigen nadat je verzoek is teruggestuurd, en een callback is goedkoper dan een strakke polling loop.
- Idempotency key. Generatie is duur, dus een opnieuw geprobeerde create zonder sleutel wordt een tweede gefactureerde taak en een dubbele afbeelding.
Valideer voordat je uitgeeft. Controleer eerst de beeldverhouding, de model-ID en de vereiste velden in je eigen code. Een lokale schema-check vangt de klasse van fouten op die anders als een 400 verschijnt na een wachtrij, en het houdt misvormd verkeer volledig weg van een gemeten endpoint.
De antwoordzijde is waar teams assets verliezen waarvoor ze al hebben betaald. OpenAI's image API reference toont de vorm waar de meeste providers naar convergeren: een afbeeldingsobject met een base64 payload, een gehoste URL en, indien ondersteund, een herziene prompt. Normaliseer wat de provider ook retourneert naar je eigen stabiele schema, en bewaar een ruw provider-metadata-blok voor controls die je schema nog niet modelleert.
| Veld | Wat het bevat | Productienotitie |
|---|---|---|
| Asset URL | link naar het gegenereerde bestand | kortlevend en toegangsbeveiligd, dus download voordat het verloopt |
| b64_json | base64-gecodeerde afbeeldingsbytes | prima voor kleine synchrone antwoorden, zwaar voor het geheugen bij grote payloads |
| revised_prompt | de prompt zoals het model die heeft herformuleerd | sla het op, want het verklaart outputs die je niet verwachtte |
| Model-ID | het model en de versie die de output produceerde | vereist voor audit en reproductie |
| Afmetingen en formaat | breedte, hoogte en MIME type | bevestig tegen de gevraagde beeldverhouding |
| Checksum | integriteitshash van het bestand | verifieer na download en na elke formaatconversie |
Behandel base64 als een transportdetail, niet als een opslagstrategie. Een gecodeerde afbeelding blaast de payload met ongeveer een derde op en blijft in het geheugen terwijl je app JSON parset. Voor productiemedia schrijf je de gedecodeerde bytes naar object storage en geef je je front-end in plaats daarvan een ondertekende ophaal-URL. Voeg het MIME type en een checksum toe aan de record terwijl je bezig bent, zodat een corrupte download wordt opgevangen door je pipeline in plaats van door een gebruiker.
De regel die ik zou afdwingen in code review: elke opgeslagen asset draagt de model-ID, de seed, de effectieve prompt en de request timestamp in zijn metadata. Zonder die vier heeft een supportticket over "een rare afbeelding van vorige maand" geen antwoord.
Die gewoonte loont de eerste keer dat een modelversie onder je verandert en de output afwijkt. De opgeslagen metadata verandert een vage klacht in een vergelijking die je kunt uitvoeren.
Asynchrone taken, taakstatussen en resultaatophaling
Beeld- en videowerk wordt niet geretourneerd binnen een chat voltooiing. Maak een taak aan, bewaar de identificatie, en volg de voortgang.
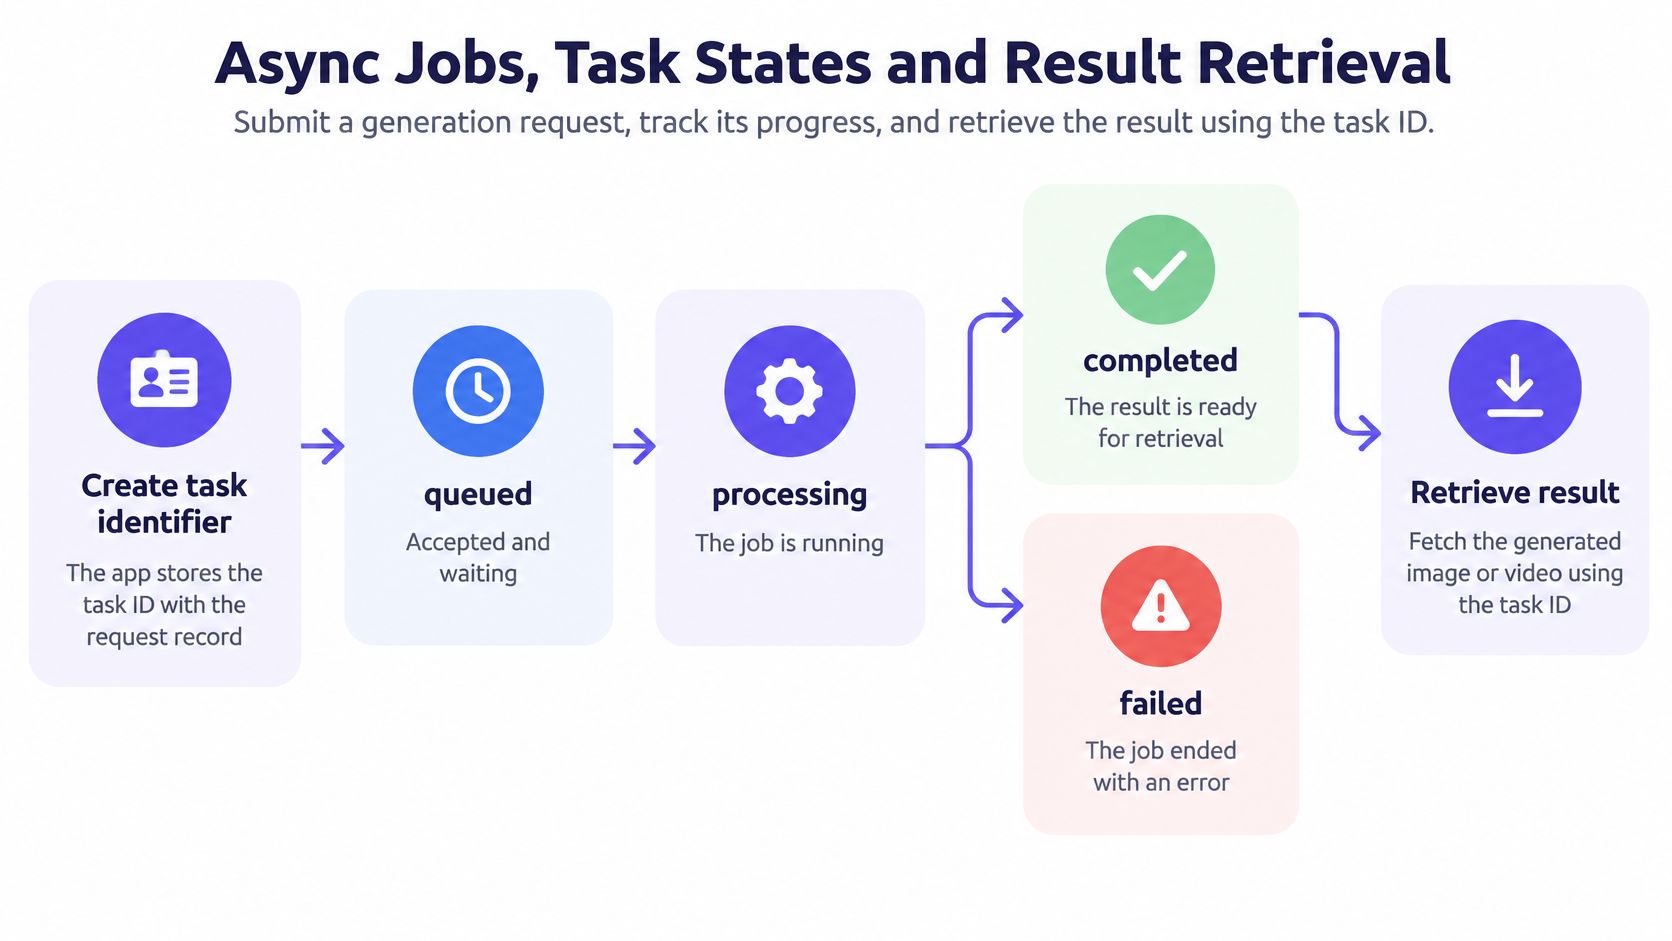
De aanroep voor het aanmaken retourneert een taakidentificatie, en uw applicatie schrijft deze naar hetzelfde aanvraagrecord dat de prompt en het model bevat. Vanaf dat moment rapporteert de taak een van de vijf statussen, en elk vraagt iets anders van uw code.
| Status | Betekenis | Wat de app doet |
|---|---|---|
| in wachtrij | geaccepteerd en wachtend op capaciteit | bewaar de taak-ID en poll volgens een schema |
| actief | generatie bezig | wacht, en handhaaf een timeout die is afgestemd op de modaliteit |
| geslaagd | uitvoer is klaar | download en bewaar de asset onmiddellijk |
| mislukt | generatie niet voltooid | lees de foutcategorie voordat u opnieuw probeert |
| verlopen | uitvoer is niet langer opvraagbaar | genereer opnieuw, en behandel het niet als een ontbrekend resultaat |
De status verlopen verrast teams omdat het lijkt op een bug in hun eigen systeem. Dat is het niet. Providers bewaren resultaatbestanden voor een beperkte periode, en die periode is kort. Op MartLLM blijven afbeeldingslinks ongeveer 15 minuten actief, en video- en muziekresultaatbestanden worden ongeveer 3 uur bewaard nadat de taak is voltooid. Een polling loop die elke tien minuten controleert en handelt bij de volgende implementatiecyclus zal afbeeldingslinks volledig missen.
Ophaling werkt via twee mechanismen, en volwassen systemen gebruiken beide. Polling dekt de leveringen die een webhook heeft gemist, en het is de enige optie wanneer uw service geen openbaar endpoint kan blootstellen. Webhooks verminderen verspilde aanvragen door u precies te vertellen wanneer de status is gewijzigd, wat belangrijk is wanneer een taak een minuut duurt in plaats van een seconde. De afwegingen tussen webhooks en polling komen neer op foutafhandeling: webhooks falen wanneer uw ontvanger niet werkt, en polling faalt duur wanneer uw interval te krap is.
Polling-intervallen moeten de modaliteit volgen, niet de codebase. Een enkele vaste loop die werkt voor een afbeeldingsstaak van 4 seconden verspilt tientallen aanroepen aan een videotaak die een minuut of langer duurt.
Tekstantwoorden streamen token voor token terug, terwijl beeld- en videotaak u een taak geven die u pollt of die een webhook als klaar rapporteert. Dat verschil is architectonisch, niet cosmetisch: de aanvraag die direct retourneert, bezit nog steeds werk dat niet is voltooid, en iemand moet het onthouden. Log de statusovergangstijden evenals de uiteindelijke status, want de kloof tussen in wachtrij en actief is waar capaciteitsproblemen zich voordoen voordat ze gebruikers bereiken.
Criteria voor modelselectie en hoe deze te testen
Openbare ranglijsten beoordelen modellen op prompts die niemand in jouw product ooit zal versturen. Ze meten de kwaliteit van samples onder omstandigheden die je niet beheert, en ze zeggen niets over latentiepieken, weigeringsconsistentie of hoe outputs verschuiven tussen builds. Een testset, opgebouwd uit je eigen afbeeldingscategorieën, vertelt je in één middag meer dan een leaderboard in een maand, en het overleeft de volgende modelrelease.
Evaluatie moet een meetbaar gedrag zijn, geen smaakoordeel. Formele evaluatieprogramma's behandelen beeldgeneratie op dezelfde manier als een belastingstest de doorvoer behandelt: gedefinieerde protocollen, vaste inputs en gescoorde outputs in plaats van indrukken van reviewers. Een productie-API moet bij elke aanroep dezelfde reproduceerbare dimensies loggen: promptcategorie, model en versie, seed indien beschikbaar, resolutie, latency, storingsmodus en veiligheidsresultaat. Log latency per verzoek zodat de piek zichtbaar blijft, want een gezonde mediaan kan bovenop taken liggen die lang genoeg blijven hangen om je timeout te bereiken.
| Criterium | Hoe te meten | Geslaagd signaal |
|---|---|---|
| Promptnaleving | beoordeelde review van een vaste promptset per categorie | vereiste objecten, aantallen en kleuren verschijnen in de meeste outputs |
| Perceptuele kwaliteit | blinde side-by-side review door het team | reviewers kiezen outputs zonder te weten welk model ze heeft gemaakt |
| Tekstweergave | prompts die exacte woorden of labels vereisen | woorden zijn correct gespeld in de meeste samples |
| Identiteitsconsistentie | hetzelfde onderwerp over meerdere generaties | het gezicht, product of karakter blijft herkenbaar |
| Weigeringsgedrag | prompts die geweigerd moeten worden | weigeringen zijn consistent en vallen in duidelijke categorieën |
| Reproduceerbaarheid | herhaalde aanroepen met dezelfde seed en modelversie | outputs blijven vergelijkbaar wanneer seed en versie overeenkomen |
Beoordeel elke rij afzonderlijk. Een geaggregeerd getal verbergt een model dat productlabels perfect weergeeft en elke prompt met een kind weigert, of een model met prachtige portretten en tekst die leest als een CAPTCHA. De storing die pijn doet, is altijd categoriespecifiek, en het middelen ervan tot één score is hoe het onopgemerkt de productie bereikt.
Routing voegt een governanceprobleem toe dat de modeltest niet zal opvangen. Wanneer een marktplaats of failover-laag providers wisselt, moet de vervanging gelijkwaardige moderatiegaranties bieden, of het resultaat moet expliciet worden gemarkeerd als hebbende verschillende zekerheidskenmerken. Stille versoepeling van veiligheidscontroles is het slechtst mogelijke failover-gedrag: er treden geen fouten op, en de output komt gewoon aan met een zwakkere controle erachter. Houd moderatiebeslissingen en modelversies bij in het auditlogboek, en exposeer foutcategorieën waarop je applicatie kan vertakken.
Steekproefgrootte die in de praktijk werkt: enkele tientallen prompts per categorie voor een eerste ronde, met de exacte prompts en outputs opgeslagen in een repo. Voer de hele set opnieuw uit wanneer een modelversie-string verandert, niet wanneer iemand klaagt.
Dat laatste punt is degene die teams overslaan. Een model-ID kan naar een nieuwe build verwijzen zonder enige wijziging aan jouw kant, dus de testset is geen lanceerartefact, het is een regressiesuite die bij elke releasecyclus draait. Wanneer de resultaten naar belanghebbenden buiten engineering gaan, geeft een duidelijke uitleg in gewone taal van wat een enkel model doet, uitgelegd door ImagesArt AI, dat gesprek een gedeelde basis voordat het scoringsdebat begint.
Getrouwheid en herkomst van bewerkingen controleren vóór de lancering
Een mooi ogende bewerking is geen succesvolle bewerking. Bewerkingen moeten twee keer worden beoordeeld: één keer of de gevraagde wijziging heeft plaatsgevonden en één keer of al het andere op zijn plaats is gebleven, en alleen op de eerste score leveren is hoe je een productfoto krijgt waarbij het model het logo opnieuw heeft getekend.
Het onderzoek ondersteunt de tweedeling. Het HQ-Edit-artikel introduceert Alignment en Coherence als afzonderlijke metrics en rapporteert dat fine-tuning de Alignment verbeterde met 12.3 punten en de Coherence met 5.64 punten in één geëvalueerd systeem. Twee onafhankelijk bewegende getallen is het hele argument: een output kan de instructie volgen en toch de delen vernietigen die je wilde behouden, of alles behouden en de instructie negeren.
De acceptatietest die ik vóór de lancering zou uitvoeren:
- Kies 20 tot 30 bronafbeeldingen die gezichten, gedrukte tekst, logo's en drukke achtergronden bevatten. Alleen bijgesneden productfoto's zullen een model passeren dat bij een gezicht uit elkaar valt.
- Schrijf één instructie per afbeelding en noteer de verwachte wijziging op dezelfde rij. Dubbelzinnige instructies leiden tot discussies over resultaten in plaats van bevindingen.
- Maskeer het bewerkte gebied en vergelijk de rest met de bron. De pixels buiten het masker zijn je behoudsscore, en een numerieke diff beslist wat met het blote oog niet kan.
- Beoordeel alignment en behoud in afzonderlijke kolommen, kijk dan naar de gevallen waarin ze verschillen. Dat zijn de prompts die moeten worden herschreven of het model dat moet worden vervangen.
- Haal elke output door formaat aanpassen en formaatconversie, bevestig dan dat watermerken of content credentials bewaard zijn gebleven. Herkomst die sterft in je CDN-pipeline is herkomst die je nooit hebt gehad.
- Bevestig het contentbeleid van de provider en eventuele openbaarmakingsplicht die van toepassing is in de markten waarnaar je levert. Beleid varieert per provider, en een gerouteerd verzoek kan onder een ander beleid vallen.
- Leg de keten van bewaring vast van bronbestand tot geleverd asset, inclusief welke modelversie het heeft verwerkt.
Stap vijf is degene die teams laat ontdekken. Credentials en onzichtbare watermerken zijn bewijs van herkomst, geen bewijs dat een afgebeelde gebeurtenis waar is. Betrouwbaarheid hangt af van vertrouwde identiteiten, van het ondertekeningsproces, en van de vraag of elke downstream-stap de metadata behoudt, dus formaat aanpassen, bijsnijden en opnieuw coderen hebben allemaal een controle nodig. Een herkomstsignaal verbetert de traceerbaarheid, en het kan de feitelijke authenticiteit niet vaststellen of bevestigen dat de rechten zijn vrijgegeven.
De ongemakkelijke conclusie voor iedereen die een bewerkingsfunctie bouwt: herkomst metadata beantwoordt "waar kwam dit vandaan," en het beantwoordt nooit "is deze bewering accuraat" of "hebben we de licentie." Dat blijven juridische en redactionele vragen.
Als het bewerkingsoppervlak het product is, behandel dan regiobehoud als een harde drempel in plaats van een kwaliteitsscore. Een API-gids voor fotobewerking is een nuttige aanvulling voor de endpoint- en parameterkant, en deze AskYourQA-gids voor AI-testen helpt de scoring te structureren zodat alignment en behoud niet samenvallen in één indruk.
Latentie, Fouten en Herhaalpogingen in Productie
De meeste vergelijkingen van afbeeldings-API's rangschikken de prijs per afbeelding en de voorbeeldkwaliteit, en stoppen dan. Latentie-uitlopers, foutpercentages en herstelgedrag zijn de cijfers die bepalen of je functie kapot aanvoelt, en het zijn de cijfers die niemand publiceert. Eén benchmark voor het genereren van afbeeldingen stelt ronduit dat latentie en waargenomen uptime zijn gereserveerd voor een toekomstige fase, terwijl een onafhankelijke test uitwees dat providers over het algemeen geen werkelijke latentiecijfers publiceren en zelf responstijden, error rates, cold starts en throughput moesten meten, zoals de API Benchmarks analyse van het genereren van afbeeldingen documenteert.
Meet percentielen, geen gemiddelden. Volg p50, p95 en p99 afzonderlijk voor synchrone en asynchrone afbeeldingsaanroepen, voeg dan het timeoutpercentage, de cold-start penalty, de tijd van aanmaken tot ophaalbaar resultaat, en het succesvolle-outputpercentage toe. Eén enkel gemiddelde verbergt de uitloper die gebruikers ervaren, namelijk de twee seconden waarin de meeste verzoeken landen en de veertig waarin een paar dat niet doen.
Verrassingen in timing gaan meestal over modaliteit. In onze test op 29 oktober 2026 duurde het genereren van een 5-seconde Kling 3.0 clip ongeveer 80 seconden. Er was niets mis; video kost nu eenmaal minuten waar afbeeldingen seconden kosten, en een timeout die is gekopieerd van het afbeeldingspad zal taken annuleren die normaal vorderden.
| Symptoom | Waarschijnlijke oorzaak | Oplossing |
|---|---|---|
| Taken blijven na de timeout actief | trage of niet-beschikbare provider | annuleer, probeer dan opnieuw met dezelfde idempotency key of herrouteer indien beschikbaar |
| Dubbele afbeeldingen na een netwerktimeout | create call opnieuw geprobeerd zonder een idempotency key | stuur een idempotency key mee met elk create request |
| 429 responses tijdens pieken | rate limit bereikt | trek je exponentieel terug met jitter en zet verzoeken in de wachtrij |
| 503 responses | provider of route tijdelijk niet beschikbaar | probeer later opnieuw met een limiet, en schakel alleen over als veiligheidsgaranties gelden |
| 402 responses | saldo- of betalingscontrole mislukt | vul het saldo aan, en stuur dan hetzelfde verzoek opnieuw |
| 404 responses | model identifier of route niet gevonden | controleer de identifier tegen de huidige catalogus |
| Afbeeldingslink laadt niet meer | signed URL is verlopen | download bij succes en sla het bestand op in je eigen opslag |
Probeer alleen opnieuw wat herhaalbaar is. Een 429 of een 503 is tijdelijk en verdient exponentiële backoff met jitter en een harde limiet. Een 402 of een 404 zal voor altijd identiek falen, dus repareer eerst het saldo of de model identifier. Onze API weigert aanroepen met 402, 404, 429 en 503, en de categorie is het signaal, niet alleen de HTTP status.
De tegendraadse kijk op kosten: de goedkoopste per-afbeelding API is vaak de duurste in productie. Herhaalpogingen, mislukte generaties en onvoorspelbare latentie-uitlopers duwen werk terug in je applicatie en gebruikers weer uit je funnel.
Betrouwbaarheid is al een aankoopcriterium, bij 37% van de organisaties, achter kostenoptimalisatie op 58%, modelbeschikbaarheid op 49% en snelheid op 41%, volgens dezelfde benchmarkinganalyse. En de afweging op de markt is reëel: routering over providers vermindert storingen, maar voegt ook variatie toe in wachttijd, regionale prestaties en vertraging van het veiligheidsfilter. Elk omgeleid verzoek moet worden gemeten als een eigen route, met zijn eigen percentielen, anders verbergt het geaggregeerde dashboard precies het pad dat faalt.
Hoe een Afbeeldings-API Stap voor Stap te Integreren
Een productie-integratie is een korte lijst van beslissingen, en de meeste daarvan gaan over records in plaats van requests. Hier is de volgorde die contact met echt verkeer overleeft.
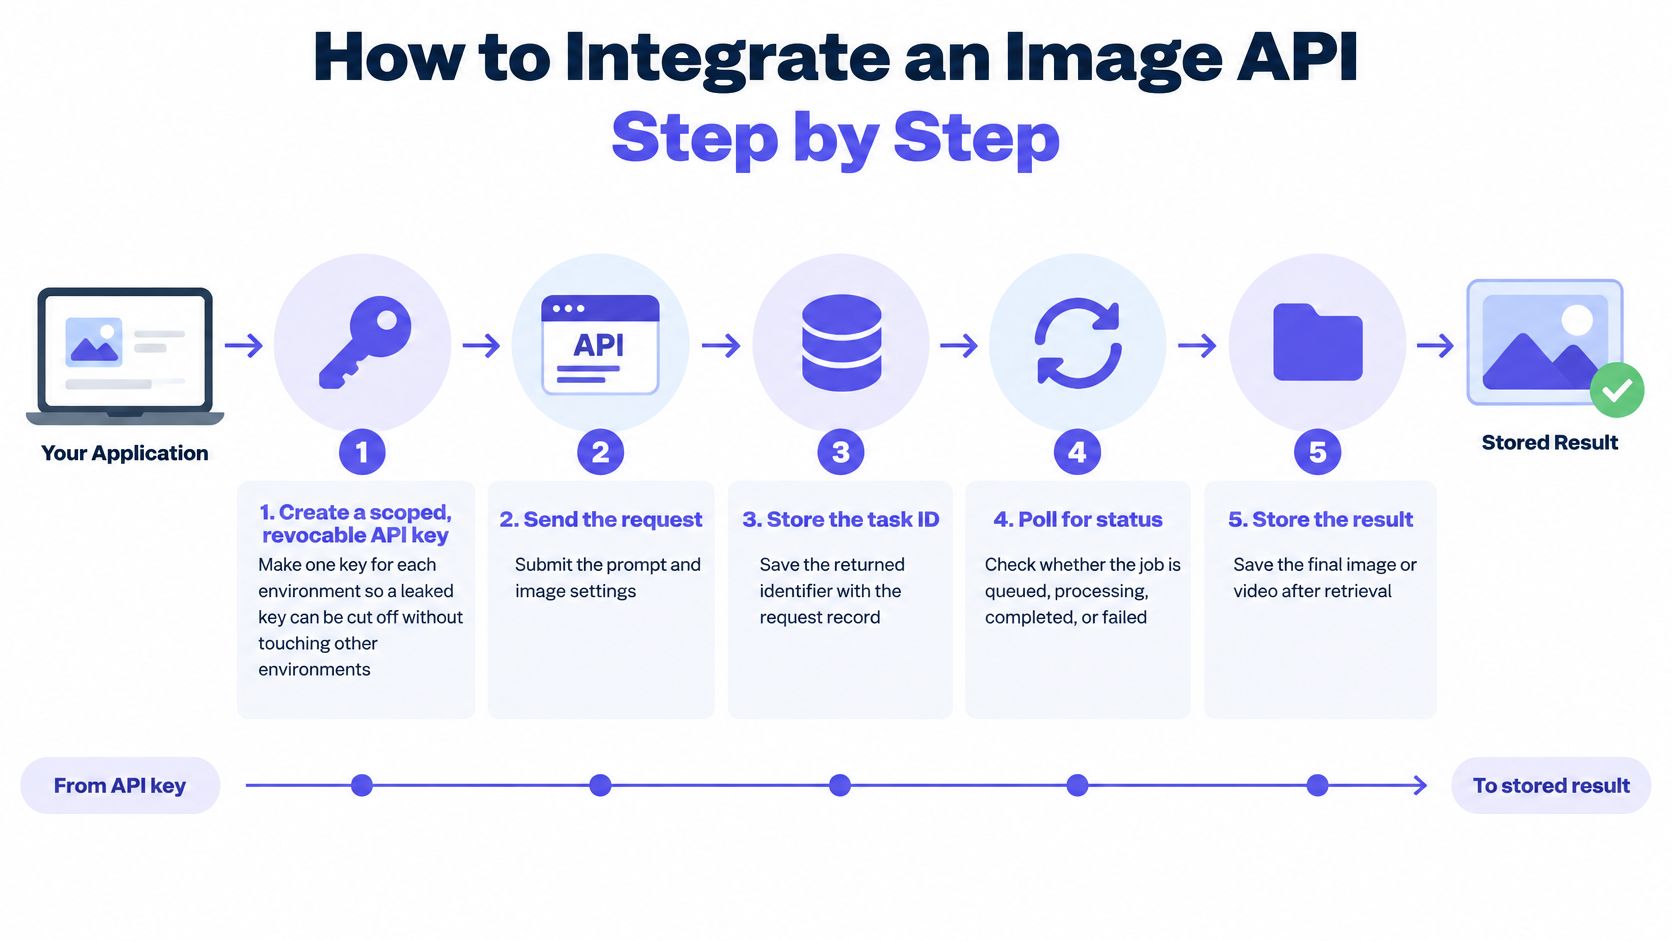
- Maak een scoped, herroepbare key voor elke omgeving. Aparte keys betekenen dat een gelekt staging-wachtwoord kan worden ingetrokken zonder het productie-verkeer te beïnvloeden.
- Wijs je bestaande client naar de nieuwe base URL. De OpenAI-compatibele base is de MartLLM OpenAI-compatibele base URL, en omdat het platform zowel OpenAI als Anthropic wire formats accepteert, werken bestaande clients zodra de base URL en credentials veranderen. Bevestig welke image endpoints waarvan je afhankelijk bent worden ondersteund voordat je overschakelt.
- Kopieer de model identifier als een volledige string uit de huidige catalogus. Het wisselen van modellen verandert dan precies één waarde, wat een one-line diff is in plaats van een refactor. Provider-native ids werken op dezelfde manier, zoals
fal-ai/kling-video/v3/standard/text-to-video. - Valideer lokaal de grootte en beeldverhouding, voeg een idempotency key toe, en verstuur dan de create call. De goedkope controles horen aan jouw kant van het netwerk thuis.
- Sla de taak-identifier op met de request record, en poll dan of registreer een webhook. Als het proces sterft tussen create en store, heb je betaald voor een output die niemand kan vinden.
- Bij succes, download de asset, verifieer de checksum en sla deze op in je eigen opslag. Wachten tot de volgende gebruikersaanvraag om het bestand op te halen, is hoe verlopende links veranderen in supporttickets.
- Log de model identifier, de state, de duration en de error category voor elke job. Die vier velden beantwoorden de meeste productievragen zonder een debugging-sessie.
- Oefen de faalpaden vóór de lancering, inclusief een 429, een request timeout en een verlopen link. Ongeteste retry-code verdubbelt meestal het aantal dubbele afbeeldingen in plaats van het te verminderen.
Een korte walkthrough is meer waard dan de veldlijst voor de eerste build, vooral rondom retrieval:
Hoe een werkende integratie er aan het einde van dit uitziet: elke job heeft een state, elke succesvolle job heeft een asset in je bucket, en elke asset heeft een gelogde modelversie ernaast. Dat is de hele standaard. Het is ook het verschil tussen een demo die iemand in maart imponeerde en een functie die je in november nog steeds kunt debuggen.
Facturatie-eenheden en hoe je echte kosten vergelijkt
Twee API's kunnen allebei "per afbeelding" zeggen en je toch anders factureren, omdat de eenheid, de afhankelijkheid van de grootte en het beleid voor mislukkingen allemaal de berekening veranderen. Vergelijk eerst de eenheid, bereken dan de kosten per bruikbare output.
| Modaliteit | Gebruikelijke facturatie-eenheid | Waarop te letten |
|---|---|---|
| Tekstgeneratie | input- en outputtokens | input en output worden afzonderlijk geprijsd |
| Afbeeldingsgeneratie | per afbeelding of per megapixel | model en outputgrootte veranderen de eenheidskosten |
| Afbeeldingsbewerking | per bewerking of per outputafbeelding | of de bronafbeelding extra kosten met zich meebrengt |
| Videogeneratie | per clip of per seconde, afhankelijk van de provider | wordt gefactureerd tegen de uiteindelijke prijs zodra de generatie is voltooid |
| Muziek en spraak | per track, per minuut of per teken | de eenheid die elk model daadwerkelijk gebruikt |
| Mislukte taken | per poging in rekening gebracht, of helemaal niet | of mislukte generaties op de factuur verschijnen |
Prijzen per megapixel bestraffen grote outputs op een manier die prijzen per afbeelding niet doen. Een model dat er goedkoop uitziet bij 1024×1024 kan meerdere keren meer kosten bij printresolutie, vergelijk dus op de grootte die je product rendert in plaats van op de grootte in de marketingscreenshot.
Video heeft een eigen regel nodig in de prognose. Een clip die tegen de uiteindelijke prijs wordt gefactureerd zodra de generatie is voltooid, is gemakkelijker te projecteren dan een die wordt gemeten terwijl deze loopt, omdat je voltooide outputs voorspelt in plaats van onzekerheid over de looptijd. Bewerkingen zijn de stiekeme rij: controleer of de bronafbeelding als input in rekening wordt gebracht, aangezien een retoucheerworkflow die een 4 MB bron bij elke aanroep verzendt, de eenheidskosten ver voorbij de geadverteerde bewerkingsprijs kan tillen.
Mislukte generaties zijn de post die uiteindelijk de doorslag geeft tussen twee leveranciers. Neem 1,000 afbeeldingstaken met een 5% foutpercentage. Als mislukte taken worden gefactureerd, betaal je voor 1,000 taken om 950 bruikbare afbeeldingen te ontvangen, wat ongeveer 5% meer per bruikbare afbeelding is dan de geadverteerde prijs doet vermoeden. Als mislukte taken niet worden gefactureerd, betaal je voor 950. Zelfde vermelde prijs, andere effectieve prijs.
De formule die ik zou gebruiken voor een maandelijkse schatting: verwacht volume × eenheidsprijs × herhaalfactor, plus een buffer voor bewerkingen en video. De herhaalfactor is het getal dat een prognose scheidt van een wens.
Vergelijk vervolgens de eenheidsprijzen met je eigen acceptatietest in plaats van met de voorbeeldgalerij van de leverancier. Als je de onderliggende logica van token-, afbeelding- en clipprijzen op één plek wilt, legt deze uitsplitsing van AI-prijsmodellen uit hoe elke eenheid wordt gemeten.
Voer een testoproep uit voordat u uw model kiest
Een testoproep moet meer beantwoorden dan “Ziet deze afbeelding er goed uit?” Controleer of het model voldoet aan uw kwaliteitsnorm, hoe het omgaat met bewerkingen en hoe de respons zich gedraagt onder verwachte belasting. Een sterke voorbeeldafbeelding kan u niet vertellen hoe de API in productie zal presteren.
Kies één kandidaat voor tekst-naar-afbeelding en één die bewerkingen ondersteunt. Houd de promptset vast over alle kandidaten heen, zodat u de uitvoer kunt vergelijken voor dezelfde taken. Met MartLLM kunt u van model wisselen door de model identifier te wijzigen, terwijl u de API key en endpoint behoudt.
Test in volgorde: eerst, beoordeel de uitvoer aan de hand van uw selectiecriteria; vervolgens, voer de bewerkingsacceptatietest uit als uw functie afbeeldingen bewerkt; meet dan de p50 en p95 latency bij verwachte concurrency. Sluit af met het berekenen van de kosten per bruikbare uitvoer, inclusief herpogingen. Een model dat de kwaliteitsnorm niet haalt, heeft geen load test nodig.
Sla prompts, uitvoer en request logs op in uw repository. Wanneer u een model identifier of versie wijzigt, voer dezelfde set opnieuw uit en vergelijk de resultaten. Voor bewerkingen, controleer of het resultaat de brondetails behoudt die uw applicatie nodig heeft; een visueel plausibele afbeelding kan nog steeds de identiteit of andere belangrijke kenmerken wijzigen.
Go of no-go: Promoot een model alleen als het de kwaliteits-, bewerkings- en load tests doorstaat bij het verwachte volume. Lever het achter een feature flag en houd een tweede kandidaat beschikbaar voor failover. Als het faalt, test de volgende kandidaat tegen dezelfde set.
Prijs hoort bij de beslissing, maar mag deze niet leiden. MartLLM vermeldt Nano Banana 2 beeldgeneratie voor $0.015 per afbeelding, vergeleken met een catalogusprijs van $0.10 per afbeelding. Voor videostests raadt MartLLM Kling 3.0 Standard aan als startpunt voor tekst-naar-video of afbeelding-naar-video. Afbeeldings- en videoverzoeken retourneren een taak die u kunt pollen of volgen via een webhook, dus neem de tijd tot voltooiing en het ophalen van het resultaat mee in uw test.
MartLLM biedt tekst-, afbeelding-, video-, muziek- en spraakmodellen via OpenAI- en Anthropic-compatibele interfaces. Gebruik de playground om afbeeldingsuitvoer te vergelijken, en voer vervolgens dezelfde testprompts uit via de API client van uw applicatie. Evalueer kwaliteit, bewerkingsgetrouwheid, latency en kosten per bruikbaar resultaat samen voordat u een model kiest.