Tổng hợp giọng hát: Cách hoạt động và những điểm còn hạn chế
Tìm hiểu cách tổng hợp giọng hát biến lời bài hát và nốt nhạc thành âm thanh giọng hát, những dữ liệu huấn luyện và vocoder nào kiểm soát, và những điểm nó vẫn còn hạn chế.
Bạn đã sáng tác một giai điệu, ghép lời vào đó và nạp một ca sĩ tổng hợp. Lần phát lại đầu tiên rất hứa hẹn, cho đến khi một từ bị lướt qua, một nốt ngân nghe chói tai như kim loại, và điệp khúc nghe vô cảm một cách kỳ lạ. Những vấn đề đó không nhất thiết có cùng nguyên nhân. Hiểu được mỗi vấn đề xuất hiện ở đâu trong chuỗi tín hiệu sẽ giúp việc khắc phục giọng hát trở nên ít phải đoán mò hơn rất nhiều.
Mục lục
- Tổng hợp giọng hát là gì và nó đến từ đâu
- Cách một hệ thống tổng hợp giọng hát biến bản nhạc thành âm thanh
- Tại sao dữ liệu huấn luyện quyết định chất lượng giọng hát tổng hợp
- Mô hình âm học và Vocoder quyết định chất lượng đạt được ở đâu
- Cách đánh giá một hệ thống tổng hợp giọng hát
- Ứng dụng thực tế, giới hạn và khoảng cách văn hóa
- Xác nhận quyền trước khi bạn xây dựng hoặc mua một mô hình giọng hát
Tổng hợp giọng hát là gì và nó đến từ đâu
Tổng hợp giọng hát (SVS) tạo ra âm thanh giọng hát từ lời bài hát, một chuỗi các nốt nhạc với cao độ và trường độ, và, trong nhiều hệ thống, một danh tính ca sĩ được chọn. Giả sử bạn là một nhạc sĩ có một giai điệu đã hoàn chỉnh nhưng không có ca sĩ nào sẵn sàng. Bạn nhập các nốt nhạc và lời bài hát để nghe xem dòng thanh nhạc phù hợp với bản phối của bạn như thế nào.
Đây không chỉ là tổng hợp giọng nói với một bản nhạc nền. Một câu nói cần có ngữ điệu đáng tin cậy, nhưng một câu hát cũng phải tuân theo cao độ âm nhạc, giữ nguyên âm và đặt phụ âm xung quanh nhịp điệu. Một âm tiết chấp nhận được trong hội thoại có thể nghe khó chịu khi kéo dài qua một nốt nhạc dài.
Từ các đoạn ghi âm đến giọng hát được học
Các phương pháp ban đầu sử dụng các quy tắc và xử lý tín hiệu, sau đó là các hệ thống lắp ghép các đơn vị giọng hát đã ghi âm. Các phương pháp thống kê và mạng nơ-ron sau đó đã học được mối quan hệ giữa lời bài hát, hướng dẫn âm nhạc và đầu ra âm thanh, thay vì chỉ dựa vào việc ghép nối các đoạn.
Theo tài liệu của Yamaha về quá trình phát triển VOCALOID, dự án bắt đầu vào tháng 2 2000 thông qua sự hợp tác DAISY với Universitat Pompeu Fabra ở Barcelona, và sản phẩm thương mại đầu tiên xuất hiện vào 2004. Các nhà phát triển cần một cơ sở dữ liệu giọng hát chuyên dụng vì đầu vào máy tính thông thường và công nghệ giọng nói truyền thống không thể tái tạo giọng hát một cách đầy đủ.
Các ca sĩ ảo như Hatsune Miku cũng đã giúp biến giọng hát tổng hợp thành một phương tiện sáng tạo tập trung vào nhân vật. Giọng hát có thể trở thành một phần của bản sắc nghệ thuật, chứ không chỉ là một bản nhạc thay thế trong một buổi thu âm.
Điểm khác biệt hữu ích: Tạo ra một màn trình diễn âm nhạc và kiểm soát một giai điệu hát từng nốt một không phải là cùng một yêu cầu.
Khi duyệt qua danh sách mô hình tạo nhạc, hãy kiểm tra các điều khiển đầu vào thay vì cho rằng mọi công cụ âm nhạc đều chấp nhận một bản nhạc thanh nhạc. Để có một hệ thống hát có thể sử dụng được, bạn cần hiểu chuỗi tín hiệu của nó, nhận ra giới hạn chất lượng của nó và thiết lập cách các giọng hát của nó có thể được đánh giá và cấp phép.
Hệ thống tổng hợp giọng hát biến bản nhạc thành âm thanh như thế nào
Đầu vào là gì, và đầu ra là gì? Trong quy trình làm việc được điều khiển bằng bản nhạc, đầu vào là một tập hợp các chỉ dẫn âm nhạc. Đầu ra là một dạng sóng mà bạn có thể phát, chỉnh sửa và phối trộn.
Các giai đoạn trong quy trình của hệ thống tổng hợp giọng hát
| Giai đoạn | Đầu vào | Đầu ra | Điều khiển gì |
|---|---|---|---|
| Giao diện tiền xử lý lời và bản nhạc | Lời bài hát, cao độ và trường độ nốt nhạc | Chuỗi âm vị với thời gian | Âm thanh nào được hát vào nhịp nào |
| Mô hình trường độ và cao độ | Âm vị và bản nhạc | Thời gian cấp khung và đường cong cao độ | Vibrato, cách bắt đầu nốt và độ chính xác cao độ |
| Mô hình âm học | Âm vị, thời gian, cao độ và danh tính ca sĩ | Mel-spectrogram | Âm sắc, hình dạng nguyên âm và cách phát âm |
| Vocoder | Mel-spectrogram | Dạng sóng âm thanh | Độ rõ nét, độ khàn và các lỗi âm thanh |
Hình minh họa cho thấy luồng tổng thể, với các quyết định về trường độ và cao độ được tích hợp vào quá trình dự đoán.
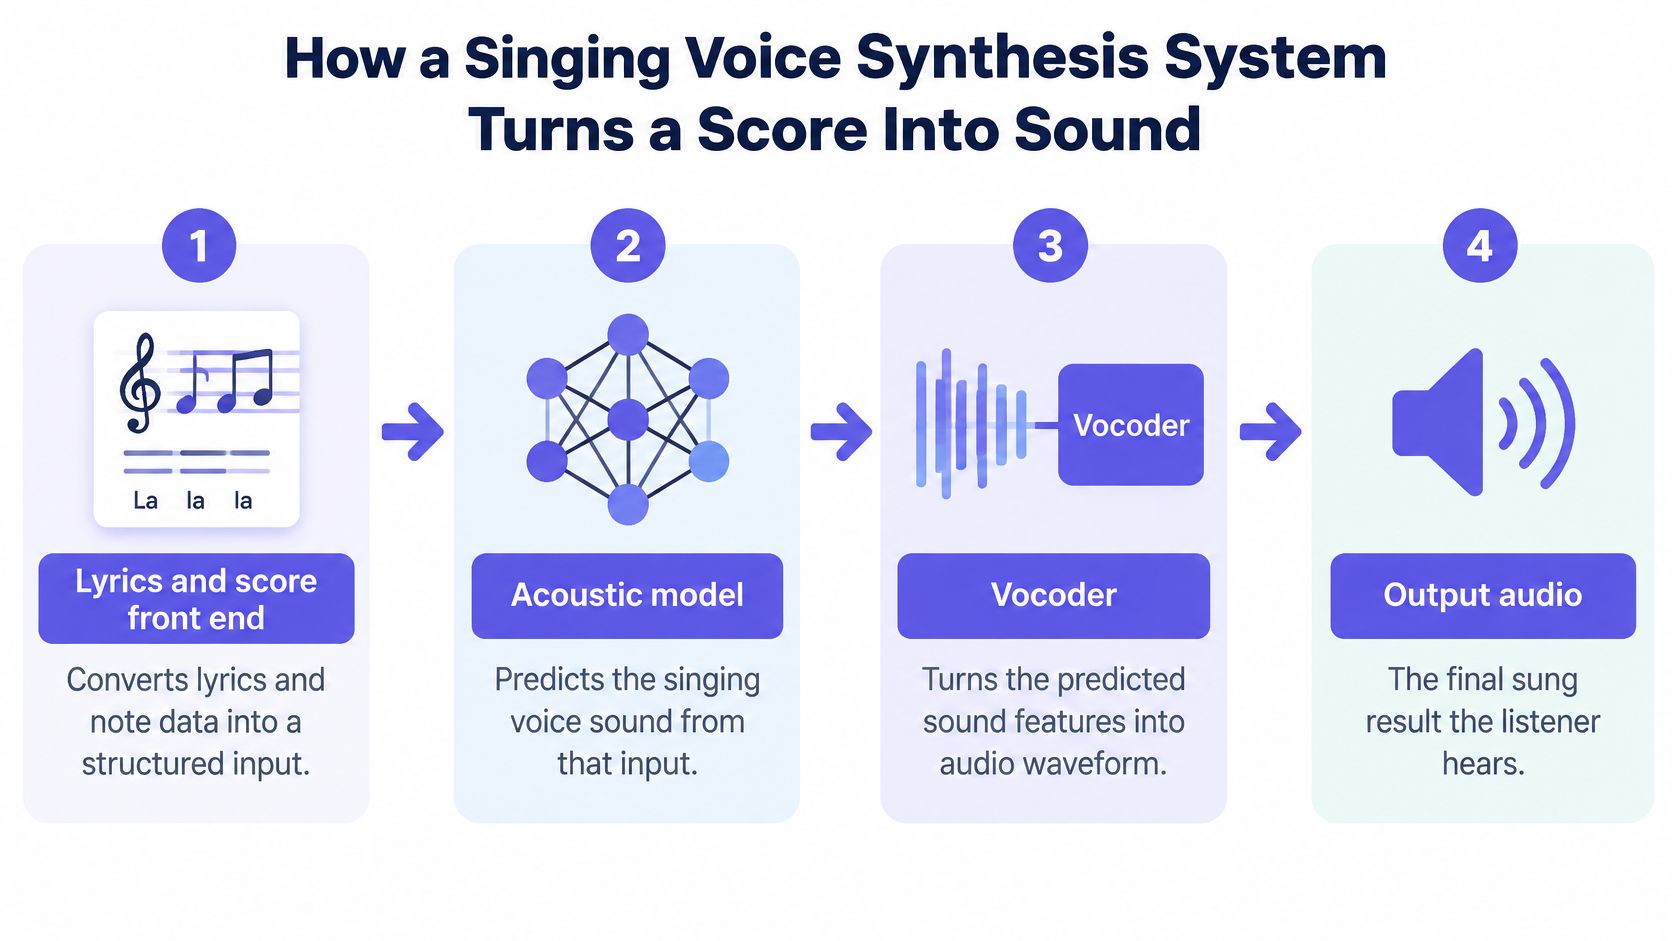
Biến lời và nốt nhạc thành một màn trình diễn
Giao diện tiền xử lý phân tách lời bài hát thành các âm vị, tức là các âm thanh lời nói riêng lẻ trong từ, và liên kết chúng với các nốt nhạc. Một âm tiết được viết ra không phải là một âm thanh duy nhất không bị gián đoạn. Trong từ stay, các phụ âm mở đầu cần được xử lý khác với nguyên âm mang cao độ được giữ.
Nếu hệ thống phân bổ quá nhiều thời gian cho các phụ âm, nguyên âm có thể đến muộn. Nếu nó rút ngắn nguyên âm để bù đắp, từ đó sẽ nghe vội vàng mặc dù nốt nhạc kết thúc đúng lúc. Hãy bắt đầu với cách phát âm và vị trí âm vị khi một lời bài hát có cảm giác sai nhịp điệu.
Mô hình trường độ và cao độ quyết định cách các âm thanh đó diễn ra theo thời gian. Nốt nhạc chỉ định một cao độ mục tiêu, nhưng đường cong cao độ được thể hiện có thể bao gồm một cách tiếp cận nhẹ nhàng, một trung tâm ổn định và vibrato về cuối. Một đường cong hoàn toàn phẳng có thể nghe cứng nhắc; một chuyển đổi quá mức có thể nghe như một cú lướt không chủ ý.
Một số công cụ chấp nhận dữ liệu nốt nhạc rõ ràng, trong khi những công cụ khác tạo hoặc suy luận giai điệu từ các đầu vào ít bị ràng buộc hơn, bao gồm cả lời bài hát. Sự khác biệt đó quyết định liệu bạn có thể sửa trực tiếp một nốt nhạc cụ thể hay phải yêu cầu một màn trình diễn khác.
Biến mô tả màn trình diễn thành âm thanh
Mô hình âm học dự đoán một biểu diễn như mel-spectrogram, mô tả cách năng lượng âm thanh được phân bổ theo tần số qua thời gian. Hãy nghĩ về nó như một bản đồ thay đổi về âm sắc của giọng nói, chứ không phải là một tệp âm thanh mà bạn đã có thể nghe được.
Các đặc điểm quang phổ được xác định kém có thể tạo ra các nguyên âm mờ nhạt, phụ âm bị mờ hoặc một danh tính giọng hát không ổn định. Nhưng chỉ riêng sự mờ nhạt không chứng minh rằng mô hình âm học là nguyên nhân. Bộ tạo dạng sóng cuối cùng cũng có thể làm mờ các chi tiết hữu ích.
Vocoder chuyển đổi biểu diễn được dự đoán thành các mẫu âm thanh. Tiếng ù, độ hạt hoặc các kết cấu kim loại có thể bắt nguồn từ đây, đặc biệt là trên các nguyên âm được giữ kéo dài.
Trước khi chỉnh sửa, hãy xác định liệu công cụ có chấp nhận nốt nhạc hay không và những điều khiển nào ảnh hưởng đến giai đoạn bị nghi ngờ. Đừng cố gắng sửa một phụ âm sai vị trí bằng cân bằng âm thanh, hoặc một dạng sóng thô bằng cách viết lại một lời bài hát được phát âm đúng.
Tại sao Dữ liệu Huấn luyện Quyết định Giọng hát Hay đến mức nào
Thu âm giọng hát chỉ là một phần của việc xây dựng một bộ dữ liệu hữu ích. Các nhà phát triển cũng cần lời bài hát đáng tin cậy, căn chỉnh nốt nhạc, phoneme timing và các chú thích phân biệt biểu cảm dự định với lỗi sai. Nếu không có ngữ cảnh đó, một mô hình có thể học một sự kiện âm thanh mà không biết khi nào nó phù hợp.
So sánh kho ngữ liệu trong khảo sát bộ dữ liệu giọng hát minh họa quy mô hạn chế và phạm vi ca sĩ của một số tài nguyên có ảnh hưởng, được tóm tắt dưới đây.
Các bộ dữ liệu giọng hát theo kích thước và phạm vi phủ sóng
| Kho ngữ liệu | Ca sĩ | Giờ | Nội dung bao gồm |
|---|---|---|---|
| VocalSet | 20 | Khoảng 10.1 | Kỹ thuật thanh nhạc, nguyên âm và cao độ đa dạng, không phải bài hát hoàn chỉnh |
| NUS-48E | 12 | Khoảng 2.8 | Kho ngữ liệu nhỏ với số lượng ca sĩ hạn chế |
| MIR-1K | 19 | Khoảng 2.2 | Kho ngữ liệu nhỏ với số lượng ca sĩ hạn chế |
| CSD | 1 | Khoảng 4.9 | 100 bài hát bằng hai ngôn ngữ từ một ca sĩ |
| SingNet | Không được chỉ định trong bản tóm tắt được trích dẫn | Khoảng 3,000 | Giọng hát tự nhiên và gói mẫu trên nhiều ngôn ngữ và phong cách |
Bản bài báo khoa học SingNet báo cáo 2,629 giờ giọng hát tự nhiên và 321 giờ từ các gói mẫu, tổng cộng khoảng 3,000 giờ. Điều này thể hiện sự mở rộng đáng kể về tài liệu có sẵn, nhưng kích thước bộ sưu tập không phải là chứng nhận về phạm vi phủ sóng âm nhạc.
Phạm vi phủ sóng quan trọng không kém thời lượng
Việc VocalSet tập trung vào kỹ thuật, nguyên âm và cao độ làm cho nó hữu ích cho việc nghiên cứu hành vi giọng hát. Nó không làm cho nó có thể thay thế được với một kho ngữ liệu gồm các bài hát hoàn chỉnh, được diễn đạt một cách biểu cảm. Tương tự, một bộ sưu tập chỉ có một ca sĩ có thể mang lại sự nhất quán mà không chứng minh được rằng một hệ thống sẽ tổng quát hóa trên các danh tính giọng hát khác nhau.
Overfitting có nghĩa là một mô hình trở nên quá phụ thuộc vào các mẫu trong tài liệu huấn luyện của nó. Trong việc nghe thực tế, điều đó có thể có nghĩa là một nguyên âm quen thuộc nghe thuyết phục nhưng một cách phát âm không quen thuộc lại gượng gạo, hoặc một kết quả mạnh mẽ trong một phong cách được đại diện nhưng lại không thuyết phục ở những nơi khác.
Để lựa chọn mô hình, hãy xem xét:
- Phạm vi ca sĩ: Tìm kiếm các quãng giọng và danh tính được ghi lại, không chỉ tổng thời lượng thu âm.
- Phạm vi ngôn ngữ: Kiểm tra xem ngôn ngữ lời bài hát và các quy ước phát âm của bạn có được đại diện hay không.
- Phạm vi âm nhạc: Phân biệt các bài tập riêng lẻ với các cụm từ hoàn chỉnh, chuyển tiếp và biểu cảm duy trì.
- Chất lượng chú thích: Tìm kiếm giải thích về cách lời bài hát và nốt nhạc được căn chỉnh với các bản ghi âm.
Câu hỏi hữu ích không chỉ là nhà phát triển đã thu thập bao nhiêu âm thanh. Mà là mức độ phù hợp của tài liệu được ghi lại với hiệu suất bạn cần. Thiếu tài liệu sẽ hạn chế mức độ tự tin bạn có thể áp dụng một tuyên bố chất lượng vượt ra ngoài một bản trình diễn bóng bẩy.
Mô hình âm thanh và Bộ mã hóa giọng nói: Nơi chất lượng được định đoạt
Bộ tạo dạng sóng có thể thay đổi đáng kể chất lượng giọng hát cảm nhận được ngay cả khi bộ dự đoán đầu vào không đổi. Điều này biến bộ mã hóa giọng nói thành một lựa chọn kỹ thuật, chứ không chỉ là một bước xuất.
Trong một nghiên cứu tổng hợp giọng hát thần kinh có kiểm soát, các mô hình âm thanh dựa trên CNN đã vượt trội hơn các mạng truyền thẳng tương ứng trong các bài kiểm tra độ tự nhiên, và việc thay thế bộ mã hóa giọng nói MLSA truyền thống bằng WaveNet đã cải thiện cả hai họ mô hình. Nghiên cứu được đào tạo trên 55 bài hát thiếu nhi Nhật Bản và 55 bài hát J-pop, giữ lại năm bài hát J-pop, và sử dụng điểm đánh giá trung bình năm điểm từ 15 người nghe để đánh giá các cụm từ thử nghiệm được chọn ngẫu nhiên. Những kết quả đó hỗ trợ một so sánh có kiểm soát, chứ không phải một xếp hạng phổ quát trên các ca sĩ, ngôn ngữ hoặc thể loại.
Tách biệt lỗi dự đoán khỏi lỗi kết xuất
Một mô hình âm thanh có thể dự đoán sai cấu trúc giọng hát. Một bộ mã hóa giọng nói có thể kết xuất một dự đoán hợp lý một cách kém chất lượng. Cả hai lỗi đều có thể nghe có vẻ nhân tạo, nhưng việc thay thế cùng một thành phần sẽ không khắc phục được cả hai.
Đối với một hệ thống mô-đun, hãy kiểm tra bộ mã hóa giọng nói bằng cách sử dụng các đặc trưng âm thanh được trích xuất từ một bản ghi tham chiếu sạch. Đây là một kiểm tra tái tổng hợp: bạn đang kiểm tra xem giai đoạn dạng sóng tái tạo thông tin đã tồn tại tốt đến mức nào, thay vì yêu cầu bộ dự đoán âm thanh tự tạo ra nó.
Sau đó, tổng hợp từ bản nhạc. Nếu tái tổng hợp tham chiếu rõ ràng nhưng đầu ra dựa trên bản nhạc bị mờ, hãy điều tra các đặc trưng dự đoán, căn chỉnh và điều kiện cao độ. Nếu việc tái tạo tham chiếu đã nghe có vẻ sạn, hãy giải quyết vấn đề bộ mã hóa giọng nói hoặc khả năng tương thích đặc trưng trước tiên.
Đừng thay thế toàn bộ mô hình cho đến khi bạn đã kiểm tra xem khiếm khuyết có tồn tại trước khi tạo dạng sóng hay không.
Sự phân biệt này cũng quan trọng khi đánh giá các công cụ giọng nói liền kề. Một danh sách mô hình chuyển văn bản thành giọng nói mô tả một nhiệm vụ khác; đầu ra giọng nói dễ hiểu không tự nó thiết lập chất lượng nốt kéo dài hoặc kiểm soát bản nhạc.
Chọn độ trung thực và độ trễ phù hợp với công việc thực tế
Các bộ mã hóa giọng nói tự hồi quy giống WaveNet tạo âm thanh tuần tự, điều này có thể làm tăng độ trễ. Các lựa chọn thay thế nhanh hơn, bao gồm LPCNet, có thể phù hợp hơn khi việc phát lại phản hồi nhanh là quan trọng.
Đối với kết xuất ngoại tuyến, bạn có thể chấp nhận thời gian chờ lâu hơn để giữ lại chi tiết giọng hát. Đối với sáng tác tương tác, bạn có thể ưu tiên xem trước nhanh và dành một bản kết xuất chất lượng cao hơn để xem xét.
Hãy đo lường cả thời gian tạo và các khiếm khuyết âm thanh bạn có thể nghe thấy trong quy trình làm việc dự kiến của bạn. Một bản kết xuất riêng lẻ đẹp mắt sẽ ít hữu ích hơn nếu nó làm gián đoạn mọi chỉnh sửa giai điệu nhỏ, trong khi một bản xem trước phản hồi nhanh không nên bị nhầm lẫn với đầu ra cuối cùng tốt nhất mà hệ thống có thể tạo ra.
Cách đánh giá một hệ thống tổng hợp giọng hát
Một giọng hát có thể nghe tự nhiên nhưng lại lạc nhịp, hoặc theo đúng nốt nhạc nhưng lại nghe mỏng. Không có một điểm chất lượng duy nhất nào mô tả toàn bộ màn trình diễn. Bạn cần các đánh giá từ người nghe cùng với các phép đo tín hiệu được tạo ra.
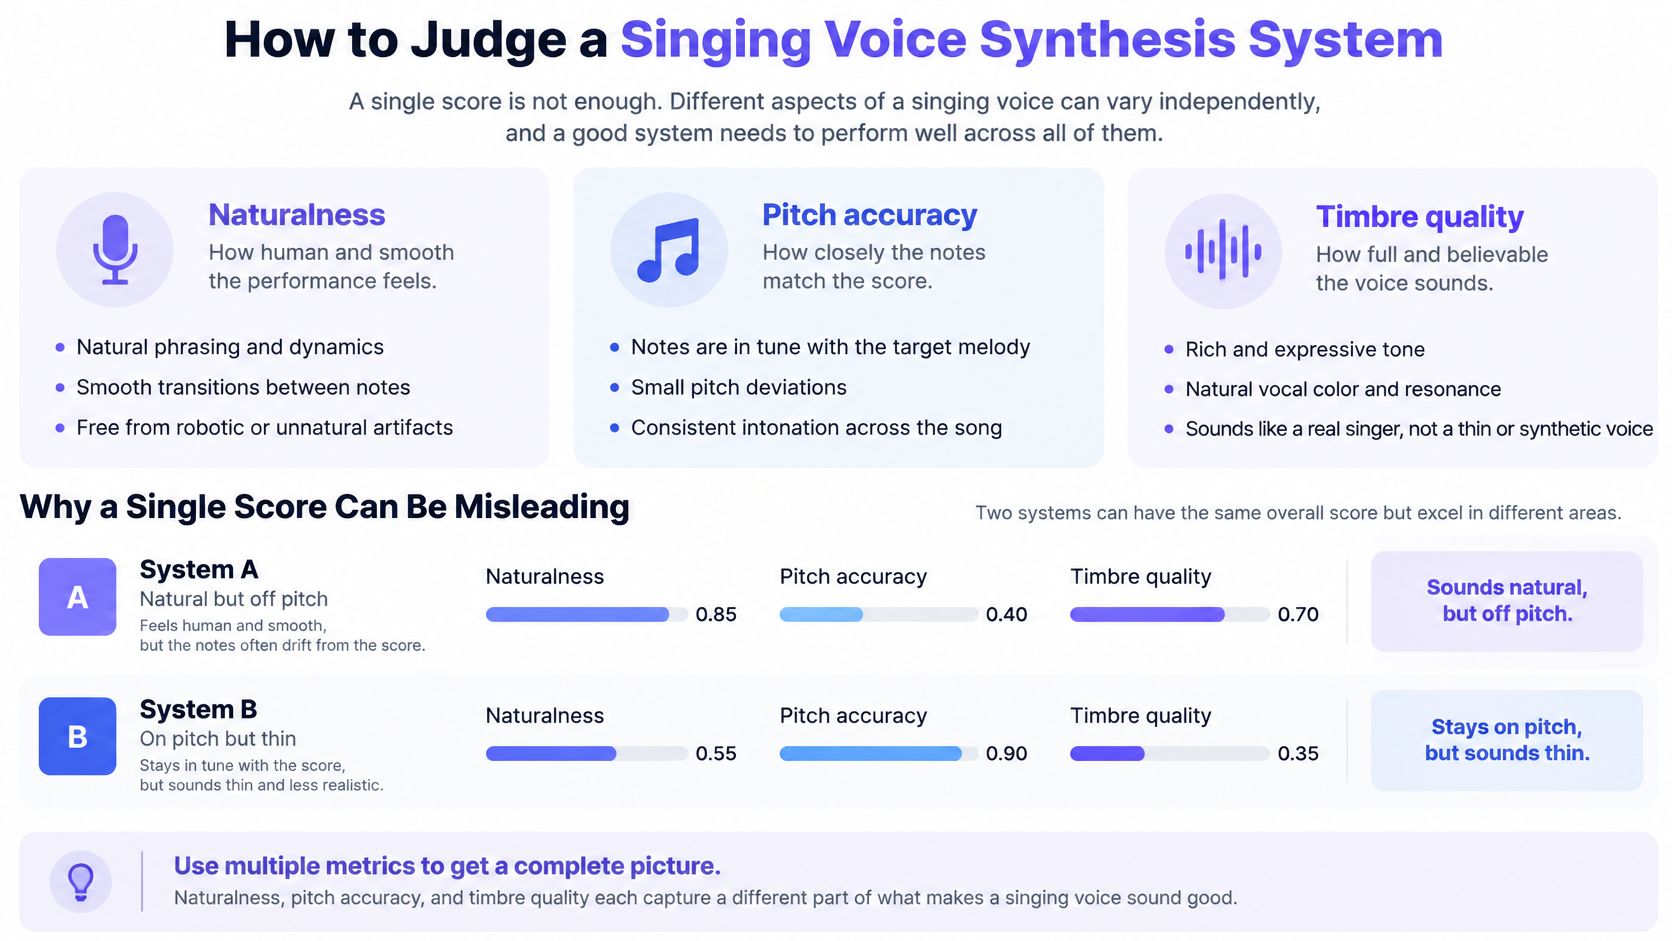
Bài báo WeSinger 2 sử dụng MOS, sai số căn bậc hai trung bình F0 và độ méo mel-spectrogram để kiểm tra các khía cạnh bổ sung về chất lượng giọng hát. Huấn luyện đối kháng có điều kiện đa ca sĩ của nó cải thiện MOS so với hệ thống WeSinger trước đó trên Opencpop và Data-L, nhưng mức tăng so sánh khác nhau giữa các tập dữ liệu, nhấn mạnh tầm quan trọng của điều kiện ca sĩ và corpus.
Các chỉ số để đánh giá chất lượng tổng hợp giọng hát
| Chỉ số | Nó nắm bắt được gì | Nó bỏ lỡ điều gì |
|---|---|---|
| MOS | Chất lượng tổng thể được người nghe cảm nhận | Có thể che giấu sự lạc nhịp và chi tiết đặc trưng của ca sĩ |
| F0 RMSE | Lỗi cao độ, ngữ điệu và điều chỉnh | Độ khàn, cách phát âm và âm sắc |
| MSD | Sự không khớp phổ liên quan đến âm sắc và cách phát âm | Liệu một cụm từ có cảm giác biểu cảm hay đúng phong cách hay không |
Đọc các phép đo cùng nhau
MOS, hay điểm ý kiến trung bình, tóm tắt xếp hạng của người nghe. Nó hữu ích để hỏi liệu mọi người có thích kết quả tổng thể hay không, nhưng việc giải thích phụ thuộc vào những gì họ đã nghe và những gì họ được yêu cầu đánh giá.
F0 RMSE đo lường lỗi trong tần số cơ bản, đại lượng âm thanh liên quan đến cao độ cảm nhận. Nó giúp tiết lộ các vấn đề điều chỉnh, nhưng nó không xác định rằng các từ có dễ hiểu hay giọng hát có đáng tin cậy hay không.
MSD so sánh các biểu diễn phổ. Nó có thể làm lộ ra sự khác biệt liên quan đến cách phát âm và âm sắc, nhưng việc khớp với một spectrogram tham chiếu không giống như việc đưa ra một lựa chọn nghệ thuật thuyết phục.
Kiểm tra nghe: Nghe giọng hát riêng lẻ trước khi đánh giá nó trong một bản phối dày đặc. Nhạc đệm có thể làm cho các phụ âm yếu và các nốt kết không ổn định khó nhận thấy hơn.
Xây dựng một bộ đánh giá bao gồm các bài hát không quen thuộc và, nếu hệ thống hỗ trợ, các ca sĩ không được huấn luyện. Bao gồm các nguyên âm kéo dài, lời bài hát nặng phụ âm, thay đổi quãng giọng và các cụm từ yêu cầu thời gian biểu cảm có chủ ý.
Báo cáo các chỉ số cùng nhau, sau đó lắng nghe cụ thể về độ khàn, cách phát âm và nhận dạng giọng hát. Nếu một nhà cung cấp chỉ đưa ra một điểm tự nhiên nổi bật, hãy coi đó là bằng chứng về bài kiểm tra nghe đó, chứ không phải là bằng chứng cho thấy lời bài hát, ca sĩ và bản phối của bạn sẽ hoạt động tốt như nhau.
Ứng dụng Thực tế, Giới hạn và Khoảng cách Văn hóa
Một nhạc sĩ có thể dùng giọng hát tổng hợp để kiểm tra xem một đoạn điệp khúc có dễ hát không trước khi sắp xếp buổi thu âm. Một nhà sản xuất có thể thử nghiệm một đoạn hòa âm, trong khi một nhóm phát triển game có thể kiểm tra xem bài hát của nhân vật có phù hợp với cảnh quay không. Đây là những ứng dụng thực tế vì phần trình diễn được tạo ra giúp mọi người đưa ra quyết định sản xuất cụ thể.
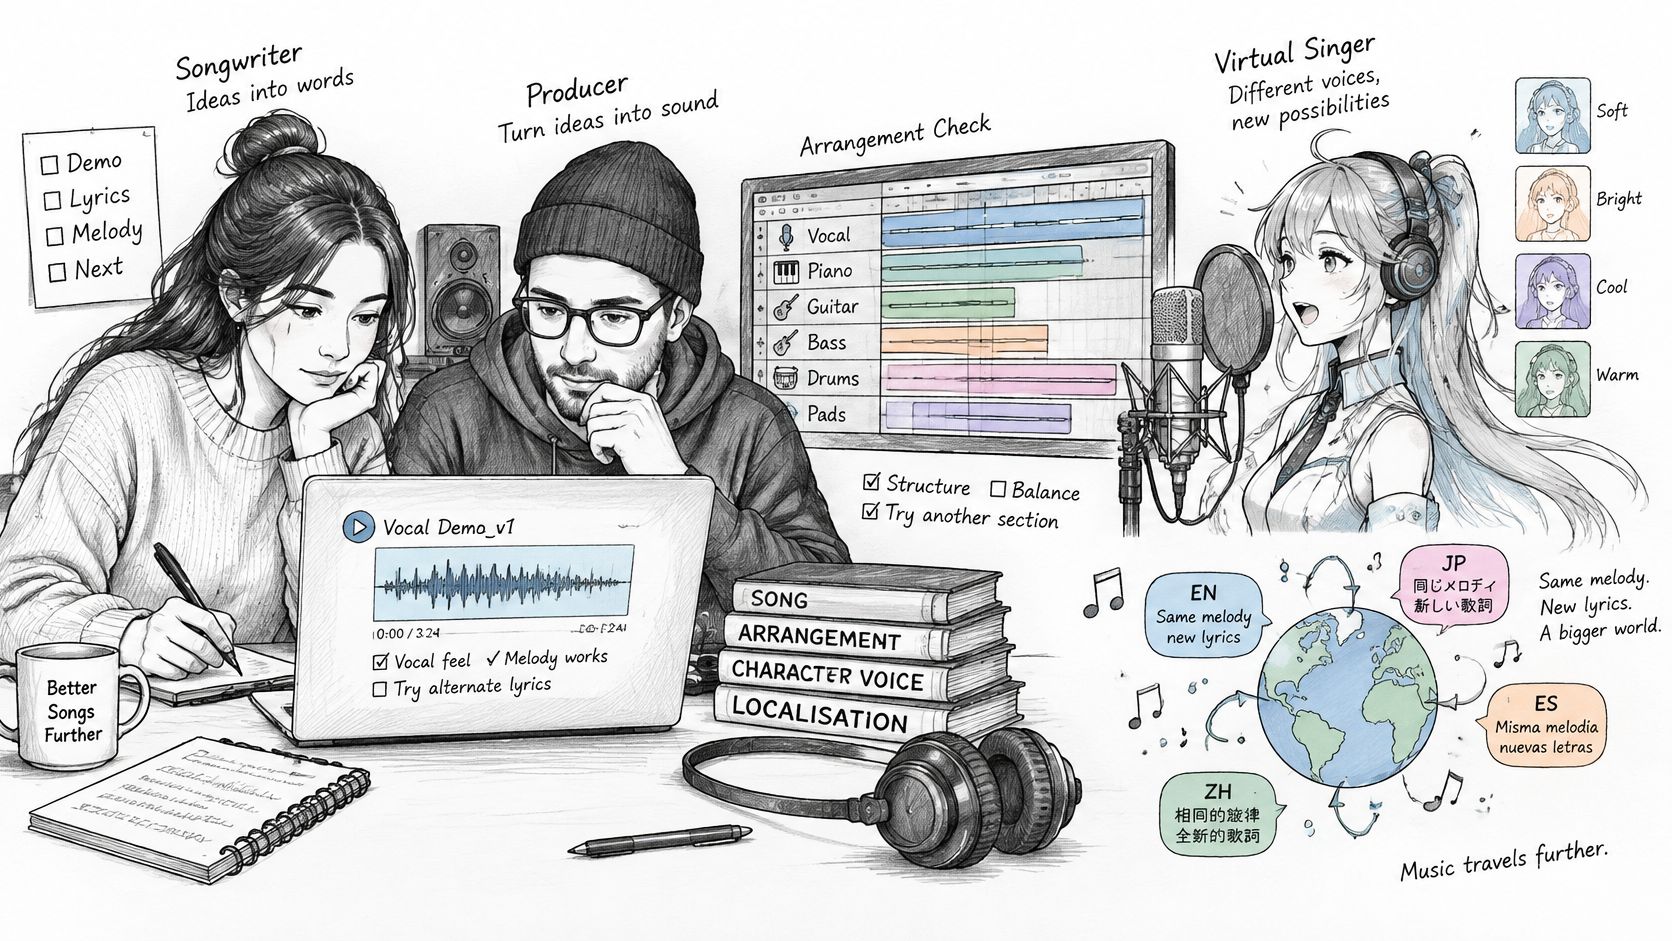
Các sản phẩm tập trung vào nhân vật và nguyên mẫu hoạt hình cũng có thể sử dụng một phong cách giọng hát tổng hợp có chủ đích. Để tạo nguyên mẫu nghe nhìn, một hướng dẫn làm video ca nhạc AI có thể giúp kết nối quy trình làm việc âm thanh với sản xuất hình ảnh, nhưng giọng hát vẫn cần được đánh giá âm nhạc riêng.
Kiểm tra biểu cảm, không chỉ nốt nhạc đúng
Bản địa hóa là một ví dụ hữu ích về việc một nhiệm vụ tưởng chừng đơn giản lại trở nên phức tạp. Giữ nguyên giai điệu trong khi thay đổi ngôn ngữ có nghĩa là phải điều chỉnh các âm tiết, mẫu trọng âm và phụ âm mới vào một cụm từ hiện có. Một bản dịch theo nghĩa đen có thể không phù hợp làm lời bài hát.
Biểu cảm đặc trưng văn hóa bổ sung thêm một lớp phức tạp khác. Chương về hát cổ điển Ấn Độ mô tả cách trang trí liên quan đến nốt nhạc cụ thể, raga, ca sĩ và bối cảnh âm nhạc, những chi tiết mà các phép đo cao độ và độ rõ ràng thông thường có thể bỏ qua.
Sử dụng các bài kiểm tra có mục tiêu thay vì chỉ hỏi liệu kết quả có giống giọng người hay không:
- Trang trí: Yêu cầu một nhạc sĩ quen thuộc với truyền thống đánh giá sự di chuyển giữa và xung quanh các nốt nhạc.
- Code-switching: Đặt một sự thay đổi ngôn ngữ vào trong một cụm từ và kiểm tra giọng điệu, trọng âm và sự liên tục của bản sắc giọng hát.
- Từ hiếm: Kiểm tra tên riêng và từ vựng lời bài hát không quen thuộc, sau đó nhờ một người nói trôi chảy đánh giá cách phát âm.
- Cách ngắt câu: So sánh nơi ca sĩ được tạo ra lấy hơi, nhấn mạnh một từ hoặc kết thúc một đoạn ngân dài.
Xác minh nguồn gốc riêng biệt với chất lượng
Một giọng hát thuyết phục không xác định được ai đã trình bày nó. Báo cáo của Viện Tư pháp Quốc gia về Thử thách Phát hiện Deepfake Giọng hát lần đầu tiên ghi nhận 47 đội tham gia và tỷ lệ lỗi ngang bằng của đội đứng đầu là 1.65% trong bối cảnh thử thách.
Kết quả đó thể hiện hiệu suất đo lường của bộ phát hiện trong các điều kiện cụ thể, không phải là sự xác thực đảm bảo cho một bản phát hành bất kỳ. Hãy coi việc phát hiện là một bước kiểm tra cùng với hồ sơ nguồn gốc, tệp nguồn và ủy quyền được ghi lại.
Hát tổng hợp đặc biệt hữu ích cho các bản nháp, nguyên mẫu và giọng nhân vật có chủ đích. Một giọng hát thương mại cuối cùng, đặc biệt là trong một bản phát hành lớn, cần được con người xem xét về biểu cảm âm nhạc, độ chính xác ngôn ngữ, danh tính và nguồn gốc thay vì chỉ chấp thuận dựa trên một bản demo nghe sạch sẽ.
Xác nhận quyền trước khi bạn xây dựng hoặc mua một mô hình hát
Ai đã cấp phép cho giọng nói trước khi nó được huấn luyện, nhân bản hoặc phát hành? Một bản ghi âm giọng hát có thể liên quan đến một người biểu diễn, một chủ sở hữu bản ghi âm, một người viết lời và một nhà soạn nhạc. Quyền liên quan đến một đóng góp không tự động giải quyết các quyền khác.
Bài viết của AI & Society về quản trị dữ liệu hát cảnh báo rằng một giấy phép Creative Commons tiêu chuẩn có thể không bảo vệ đầy đủ những người đóng góp dữ liệu hát, vì các bản ghi âm có thể chứa cả giọng hát của người biểu diễn và một bài hát được bảo vệ bản quyền. Nó cũng phân biệt các quy tắc sử dụng hợp lý của Hoa Kỳ với ngoại lệ khai thác văn bản và dữ liệu của EU thay vì coi chúng là các quyền có thể hoán đổi cho nhau.
Đặt các mục đích sử dụng được phép bằng văn bản
Sử dụng danh sách kiểm tra quyền trước khi chuyển giao bản ghi âm hoặc tích hợp một mô hình:
- Xác định các quyền liên quan. Ghi lại các quyền liên quan đến các bản ghi âm, lời bài hát, sáng tác, hình ảnh và mục đích phát hành thương mại của ca sĩ. Ghi lại ai có thể cấp phép cho mỗi mục đích sử dụng thay vì cho rằng người cung cấp tệp kiểm soát mọi thứ.
- Chỉ rõ các hoạt động của mô hình. Nêu rõ liệu thỏa thuận có cho phép huấn luyện, tinh chỉnh, nhân bản giọng nói, phân phối lại và sử dụng thương mại hạ nguồn hay không. Giấy phép xuất bản một bản nhạc âm thanh không nên trở thành quyền để xây dựng một mô hình giọng nói có thể tái sử dụng.
- Đọc các điều khoản cấp phép. Đừng chỉ dựa vào nhãn Creative Commons. Kiểm tra xem các điều khoản có đề cập đến đóng góp của người biểu diễn và bài hát gốc hay không.
- Kiểm tra thẩm quyền áp dụng. Yêu cầu luật sư có chuyên môn đánh giá các quy tắc liên quan đến các bản ghi âm, người đóng góp và việc triển khai. Đừng cấy ghép một ngoại lệ từ hệ thống pháp luật khác vào thỏa thuận của bạn.
- Lập kế hoạch cho những gì xảy ra sau khi huấn luyện. Xác định các quy trình thu hồi, gỡ bỏ mô hình, ghi công và chia sẻ doanh thu. Chỉ rõ ai xử lý các yêu cầu và những biện pháp khắc phục nào có sẵn về mặt kỹ thuật và hợp đồng.
Giữ bằng chứng cùng với tài sản sản xuất
Duy trì một hồ sơ quyền cùng với tập dữ liệu hoặc dự án. Bao gồm phiên bản thỏa thuận, các mục đích sử dụng được phép, mã định danh bản ghi nguồn và mọi hạn chế về phân phối. Điều đó giúp dễ dàng phân biệt một đầu vào được cấp phép với một tệp chỉ đơn thuần xuất hiện trong một thư mục chia sẻ.
Tính khả dụng công khai không phải là bằng chứng về sự đồng ý hoặc quyền sở hữu. Cũng không nên nhầm lẫn lời hứa gỡ bỏ một bản ghi âm với khả năng đã được chứng minh để loại bỏ ảnh hưởng của nó khỏi một mô hình đã được huấn luyện.
Trước khi xây dựng hoặc mua một mô hình hát, hãy có các điều khoản bằng văn bản bao gồm mỗi quyền liên quan, hoạt động được phép và nghĩa vụ sau huấn luyện.
MartLLM là một API cho các mô hình văn bản, hình ảnh, video, âm nhạc và giọng nói. Nếu bạn đang xây dựng một quy trình làm việc sản xuất liên quan đến hát, hãy truy cập MartLLM để khám phá danh sách mô hình và so sánh các đầu vào được ghi lại của chúng với các yêu cầu của bạn về kiểm soát điểm số, đầu ra âm thanh và các tác vụ truyền thông xung quanh.