Sintesi della Voce Cantata: Come Funziona e Dove Fallisce
Scopri come la sintesi della voce cantata trasforma testi e note in audio cantato, cosa controllano i dati di addestramento e i vocoder, e dove è ancora carente.
Hai scritto una melodia, ci hai adattato il testo e hai caricato un cantante sintetico. Il primo ascolto è incoraggiante, finché una parola non sfreccia via, una nota tenuta diventa metallica e il ritornello suona stranamente inespressivo. Quei problemi non hanno necessariamente la stessa causa. Capire dove ognuno di essi entra nella catena del segnale rende la correzione della voce molto meno un'operazione a tentoni.
Indice
- Cos'è la Sintesi Vocale Cantata e da Dove Viene
- Come un Sistema di Sintesi Vocale Cantata Trasforma uno Spartito in Suono
- Perché i Dati di Addestramento Decidono la Qualità di una Voce Cantata
- Modelli Acustici e Vocoder Decidono Dove si Vince la Qualità
- Come Giudicare un Sistema di Sintesi Vocale Cantata
- Usi Pratici, Limiti e Lacune Culturali
- Confermare i Diritti Prima di Costruire o Acquistare un Modello Cantato
Cos'è la Sintesi Vocale Cantata e da Dove Viene
La sintesi vocale cantata (SVS) genera audio cantato a partire da testi, una sequenza di note con altezze e durate e, in molti sistemi, un'identità di cantante selezionata. Immagina di essere un cantautore con una melodia finita ma senza un cantante disponibile. Inserisci le note e le parole per sentire come la linea vocale si adatta al tuo arrangiamento.
Questa non è solo sintesi vocale con una base musicale. Una frase parlata necessita di un fraseggio credibile, ma una frase cantata deve anche seguire le altezze musicali, sostenere le vocali e posizionare le consonanti attorno al battito. Una sillaba accettabile in una conversazione può suonare strana se allungata su una nota lunga.
Dai frammenti registrati alle voci apprese
I primi approcci utilizzavano regole ed elaborazione del segnale, seguiti da sistemi che assemblavano unità vocali registrate. Approcci statistici e neurali hanno successivamente appreso le relazioni tra testi, istruzioni musicali e output acustico, piuttosto che affidarsi solo all'unione di frammenti.
Secondo il resoconto di Yamaha sullo sviluppo di VOCALOID, il progetto è iniziato a febbraio 2000 tramite la collaborazione DAISY con l'Universitat Pompeu Fabra di Barcellona, e il primo prodotto commerciale è apparso nel 2004. Gli sviluppatori avevano bisogno di un database di canto dedicato perché l'input informatico ordinario e la tecnologia vocale convenzionale non potevano riprodurre adeguatamente il canto.
Cantanti virtuali come Hatsune Miku hanno anche contribuito a trasformare il canto sintetico in un mezzo creativo incentrato sul personaggio. La voce poteva diventare parte di un'identità artistica, non solo una traccia sostitutiva in una sessione di registrazione.
Distinzione utile: Generare una performance musicale e controllare una melodia cantata nota per nota non sono lo stesso requisito.
Quando sfogli un elenco di modelli di generazione musicale, controlla i controlli di input piuttosto che dare per scontato che ogni strumento musicale accetti una partitura vocale. Per un sistema di canto utilizzabile, devi comprenderne la catena del segnale, riconoscerne i limiti di qualità e stabilire come le sue voci possano essere valutate e licenziate.
Come un sistema di sintesi vocale per il canto trasforma uno spartito in suono
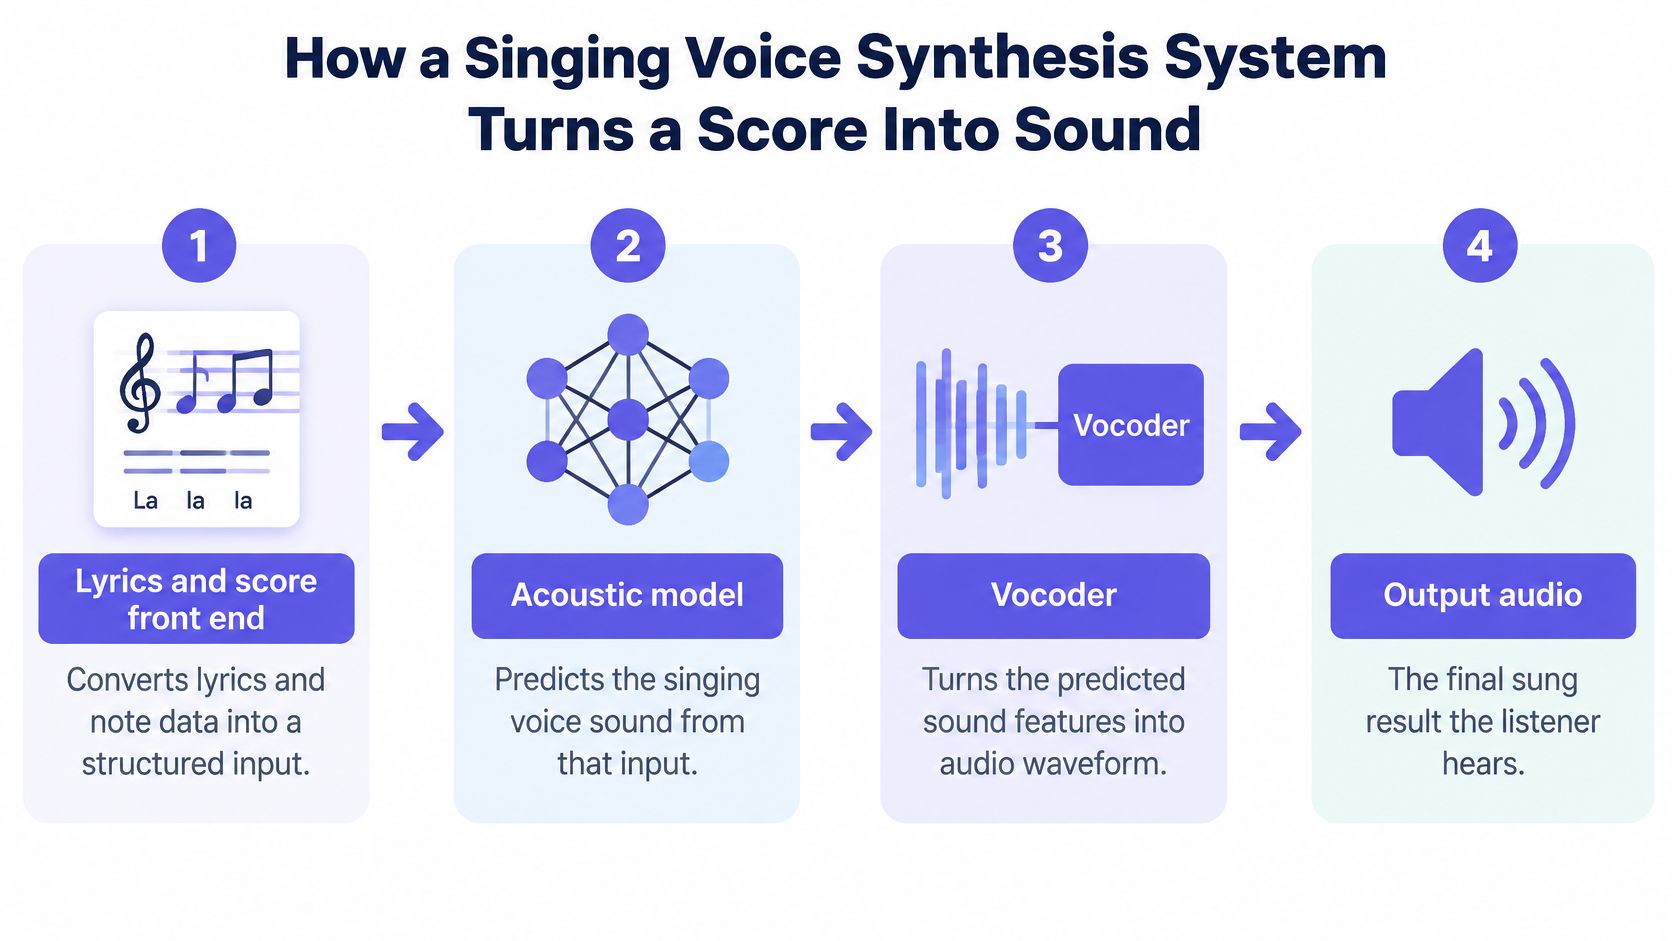
Cosa entra e cosa esce? In un flusso di lavoro controllato da spartito, l'input è un insieme di istruzioni musicali. L'output è una forma d'onda che puoi riprodurre, modificare e mixare.
Fasi della pipeline in un sistema di sintesi vocale per il canto
| Fase | Input | Output | Cosa Controlla |
|---|---|---|---|
| Front end per testi e spartito | Testi, altezza e durata delle note | Sequenza di fonemi con tempistica | Quale suono viene cantato su quale battuta |
| Modello di durata e altezza | Fonemi e spartito | Tempistica a livello di frame e curva di altezza | Vibrato, attacchi delle note e precisione dell'altezza |
| Modello acustico | Fonemi, tempistica, altezza e identità del cantante | Mel-spettrogramma | Timbro, forma delle vocali e articolazione |
| Vocoder | Mel-spettrogramma | Forma d'onda audio | Chiarezza, ariosità e artefatti udibili |
L'illustrazione mostra il flusso più ampio, con le decisioni di durata e altezza incorporate nel processo di previsione.
Trasformare parole e note in una performance
Il front end scompone i testi in fonemi, i singoli suoni del parlato all'interno delle parole, e li associa alle note. Una sillaba scritta non è un singolo suono ininterrotto. In stay, le consonanti iniziali richiedono un trattamento diverso dalla vocale che porta l'altezza sostenuta.
Se il sistema alloca troppo tempo alle consonanti, la vocale può arrivare in ritardo. Se accorcia la vocale per compensare, la parola suona affrettata anche se la nota finisce in tempo. Inizia con la pronuncia e il posizionamento dei fonemi quando un testo sembra ritmicamente sbagliato.
Il modello di durata e altezza decide come questi suoni si sviluppano nel tempo. La nota specifica un'altezza target, ma la curva di altezza eseguita può includere un approccio delicato, un centro stabile e un vibrato verso la fine. Una curva perfettamente piatta può suonare rigida; una transizione esagerata può suonare come uno scoop involontario.
Alcuni strumenti accettano dati espliciti sulle note, mentre altri generano o inferiscono una melodia da input meno vincolati, inclusi i testi. Questa differenza determina se puoi riparare una nota particolare direttamente o devi richiedere un'altra performance.
Trasformare una descrizione della performance in audio
Il modello acustico predice una rappresentazione come un mel-spettrogramma, che descrive come l'energia sonora è distribuita attraverso la frequenza nel tempo. Pensalo come una mappa mutevole del tono della voce, non un file audio che puoi già sentire.
Caratteristiche spettrali mal definite possono produrre vocali opache, consonanti sfocate o un'identità vocale instabile. Ma l'opacità da sola non prova che il modello acustico sia responsabile. Il generatore di forma d'onda finale può anche oscurare dettagli utili.
Il vocoder converte la rappresentazione predetta in campioni sonori. Ronzii, granulosità o texture metalliche possono avere origine qui, specialmente su vocali sostenute esposte.
Prima di modificare, identifica se lo strumento accetta note e quali controlli influenzano la fase sospetta. Non cercare di correggere una consonante fuori posto con l'equalizzazione, o una forma d'onda grezza riscrivendo un testo pronunciato correttamente.
Perché i dati di addestramento determinano la qualità del suono di una voce cantata
Registrare il canto è solo una parte della creazione di un dataset utile. Gli sviluppatori hanno bisogno anche di testi affidabili, allineamento delle note, tempistica dei fonemi e annotazioni che distinguano l'espressione voluta dagli errori. Senza quel contesto, un modello potrebbe imparare un evento acustico senza capire quando è appropriato.
Il confronto dei corpus nel sondaggio sui dataset di canto illustra la scala limitata e la copertura di cantanti di diverse risorse influenti, riassunte di seguito.
Dataset di canto per dimensione e copertura
| Corpus | Cantanti | Ore | Cosa Copre |
|---|---|---|---|
| VocalSet | 20 | Circa 10.1 | Tecniche vocali, vocali e intonazioni varie, non canzoni complete |
| NUS-48E | 12 | Circa 2.8 | Corpus piccolo con un pool limitato di cantanti |
| MIR-1K | 19 | Circa 2.2 | Corpus piccolo con un pool limitato di cantanti |
| CSD | 1 | Circa 4.9 | 100 canzoni in due lingue da un solo cantante |
| SingNet | Non specificato nel riassunto citato | Circa 3,000 | Canto "in-the-wild" e pacchetti di campioni attraverso lingue e stili |
Il preprint di SingNet riporta 2,629 ore di canto "in-the-wild" e 321 ore da pacchetti di campioni, per un totale di circa 3,000 ore. Ciò rappresenta un'espansione sostanziale del materiale disponibile, ma la dimensione della collezione non è un certificato di copertura musicale.
La copertura conta tanto quanto la durata
L'attenzione di VocalSet su tecniche, vocali e intonazioni lo rende utile per studiare il comportamento vocale. Non lo rende interscambiabile con un corpus di canzoni complete, fraseggiate espressivamente. Allo stesso modo, una collezione di un singolo cantante può offrire coerenza senza dimostrare che un sistema si generalizzerà tra diverse identità vocali.
Overfitting significa che un modello diventa troppo dipendente dai pattern nel suo materiale di training. Nell'ascolto pratico, ciò potrebbe significare una vocale familiare convincente ma una pronuncia sconosciuta goffa, o un risultato forte in uno stile rappresentato e un risultato poco convincente altrove.
Per la selezione del modello, esamina:
- Copertura dei cantanti: Cerca intervalli vocali e identità documentate, non solo una durata totale della registrazione.
- Copertura linguistica: Controlla se la lingua dei tuoi testi e le convenzioni di pronuncia sono rappresentate.
- Copertura musicale: Distingui gli esercizi isolati da frasi complete, transizioni ed espressione sostenuta.
- Qualità delle annotazioni: Cerca una spiegazione di come testi e note sono stati allineati con le registrazioni.
La domanda utile non è solo quanto audio ha raccolto uno sviluppatore. È quanto fedelmente il materiale documentato corrisponde alla performance di cui hai bisogno. La documentazione mancante limita la fiducia con cui puoi applicare una dichiarazione di qualità oltre una dimostrazione ben rifinita.
I modelli acustici e i vocoder decidono dove si vince la qualità
Il generatore di forme d'onda può modificare materialmente la qualità percepita del canto anche quando il predittore a monte rimane lo stesso. Questo rende il vocoder una scelta ingegneristica, non solo un passaggio di esportazione.
In uno studio controllato sulla sintesi neurale del canto, i modelli acustici basati su CNN hanno superato le corrispondenti reti feed-forward nei test di naturalezza, e la sostituzione del tradizionale vocoder MLSA con WaveNet ha migliorato entrambe le famiglie di modelli. Lo studio è stato addestrato su 55 canzoni per bambini giapponesi e 55 canzoni J-pop, ha tenuto da parte cinque canzoni J-pop, e ha utilizzato punteggi medi di opinione a cinque punti da 15 ascoltatori che valutavano frasi di test selezionate casualmente. Questi risultati supportano un confronto controllato, non una classifica universale tra cantanti, lingue o generi.
Separare gli errori di previsione dagli errori di rendering
Un modello acustico può prevedere una struttura vocale sbagliata. Un vocoder può renderizzare male una previsione ragionevole. Entrambi i fallimenti possono sembrare artificiali, ma sostituire lo stesso componente non risolverà entrambi.
Per un sistema modulare, testa il vocoder usando le caratteristiche acustiche estratte da una registrazione di riferimento pulita. Questo è un test di risintesi: stai verificando quanto bene lo stadio della forma d'onda ricostruisce informazioni che già esistono, piuttosto che chiedere al predittore acustico di inventarle.
Poi sintetizza dalla partitura. Se la risintesi di riferimento è chiara ma l'output guidato dalla partitura è confuso, indaga le caratteristiche previste, l'allineamento e il condizionamento del pitch. Se la ricostruzione di riferimento suona già granulosa, affronta prima il vocoder o la compatibilità delle caratteristiche.
Non sostituire l'intero modello finché non hai verificato se il difetto esiste prima della generazione della forma d'onda.
Questa distinzione è importante anche quando si valutano strumenti vocali adiacenti. Un elenco di modelli text-to-speech descrive un compito diverso; un output parlato intelligibile da solo non stabilisce la qualità delle note sostenute o il controllo della partitura.
Scegli fedeltà e latenza per il lavoro effettivo
I vocoder autoregressivi simili a WaveNet generano audio in sequenza, il che può aumentare la latenza. Alternative più veloci, incluso LPCNet, potrebbero essere più appropriate quando la riproduzione reattiva è importante.
Per il rendering offline, potresti accettare un'attesa più lunga per preservare i dettagli vocali. Per la composizione interattiva, potresti preferire un'anteprima rapida e riservare un rendering di qualità superiore per la revisione.
Misura sia il tempo di generazione che gli artefatti che puoi sentire nel tuo flusso di lavoro previsto. Un rendering isolato bellissimo è meno utile se interrompe ogni piccola modifica della melodia, mentre un'anteprima reattiva non dovrebbe essere scambiata per il miglior output finale che il sistema può produrre.
Come Valutare un Sistema di Sintesi Vocale Cantata
Una voce può sembrare naturale pur stonando, o seguire le note con precisione pur suonando flebile. Nessun singolo punteggio di qualità descrive l'intera performance. Hai bisogno dei giudizi degli ascoltatori insieme alle misurazioni del segnale generato.
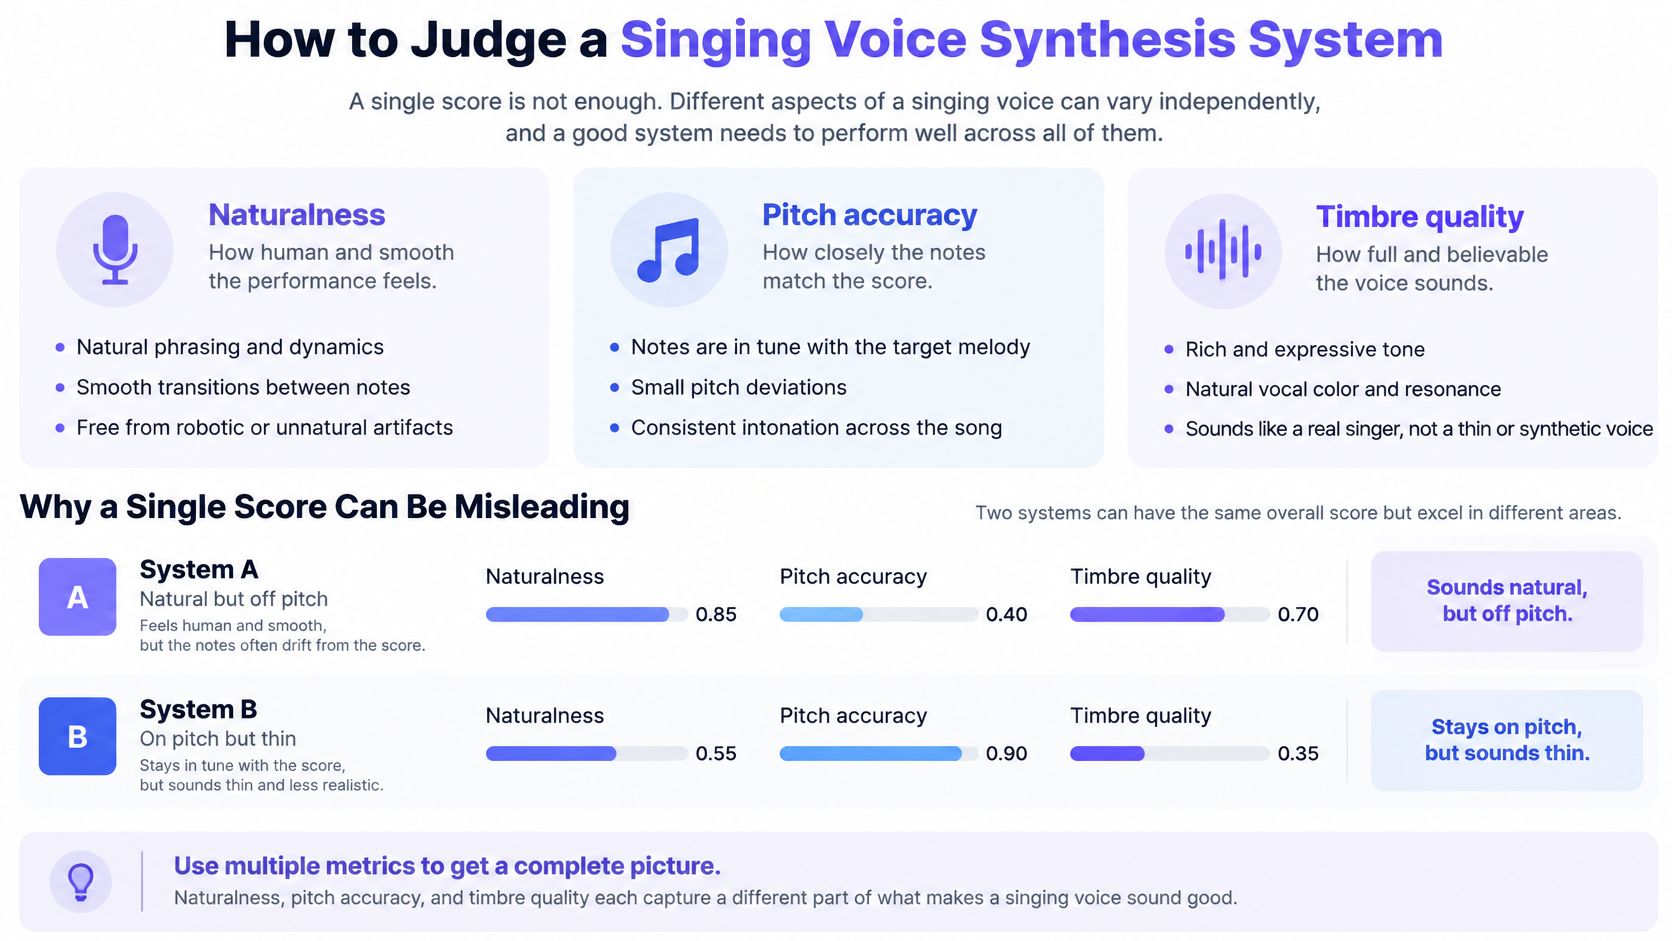
Il paper WeSinger 2 utilizza MOS, l'errore quadratico medio F0 e la distorsione mel-spettrogramma per esaminare aspetti complementari della qualità del canto. Il suo addestramento avversariale condizionale multi-cantante migliora il MOS rispetto al precedente sistema WeSinger su Opencpop e Data-L, ma i guadagni comparativi differiscono tra i dataset, sottolineando l'importanza delle condizioni del cantante e del corpus.
Metriche per valutare la qualità della sintesi vocale cantata
| Metrica | Cosa Rileva | Cosa Non Rileva |
|---|---|---|
| MOS | Qualità percepita complessiva dagli ascoltatori | Può nascondere deviazioni di intonazione e dettagli specifici del cantante |
| F0 RMSE | Errore di pitch, intonazione e accordatura | Respirazione, pronuncia e timbro |
| MSD | Discrepanza spettrale legata al timbro e all'articolazione | Se una frase risulta espressiva o nello stile |
Leggi le misurazioni insieme
MOS, o punteggio medio di opinione, riassume le valutazioni degli ascoltatori. È utile per chiedere se le persone preferiscono il risultato complessivo, ma l'interpretazione dipende da ciò che hanno ascoltato e da cosa è stato loro chiesto di giudicare.
F0 RMSE misura l'errore nella frequenza fondamentale, la quantità acustica associata al pitch percepito. Aiuta a rivelare problemi di intonazione, ma non stabilisce che le parole siano intelligibili o che il tono vocale sia credibile.
MSD confronta le rappresentazioni spettrali. Può esporre differenze legate all'articolazione e al timbro, ma confrontare uno spettrogramma di riferimento non è lo stesso che fare una scelta artistica convincente.
Controllo d'ascolto: Ascolta la voce da sola prima di giudicarla all'interno di un mix denso. L'accompagnamento può rendere più difficili da notare le consonanti deboli e le finali di nota instabili.
Crea un set di valutazione contenente canzoni sconosciute e, dove il sistema lo supporta, cantanti esclusi dal training. Includi vocali sostenute, testi ricchi di consonanti, cambi di registro e frasi che richiedono un timing espressivo deliberato.
Riporta le metriche insieme, quindi ascolta specificamente la respirazione, la pronuncia e l'identità vocale. Se un fornitore offre solo un punteggio di naturalezza principale, trattalo come prova di quel test d'ascolto, non come prova che il tuo testo, cantante e arrangiamento funzioneranno altrettanto bene.
Usi Pratici, Limiti e Lacune Culturali
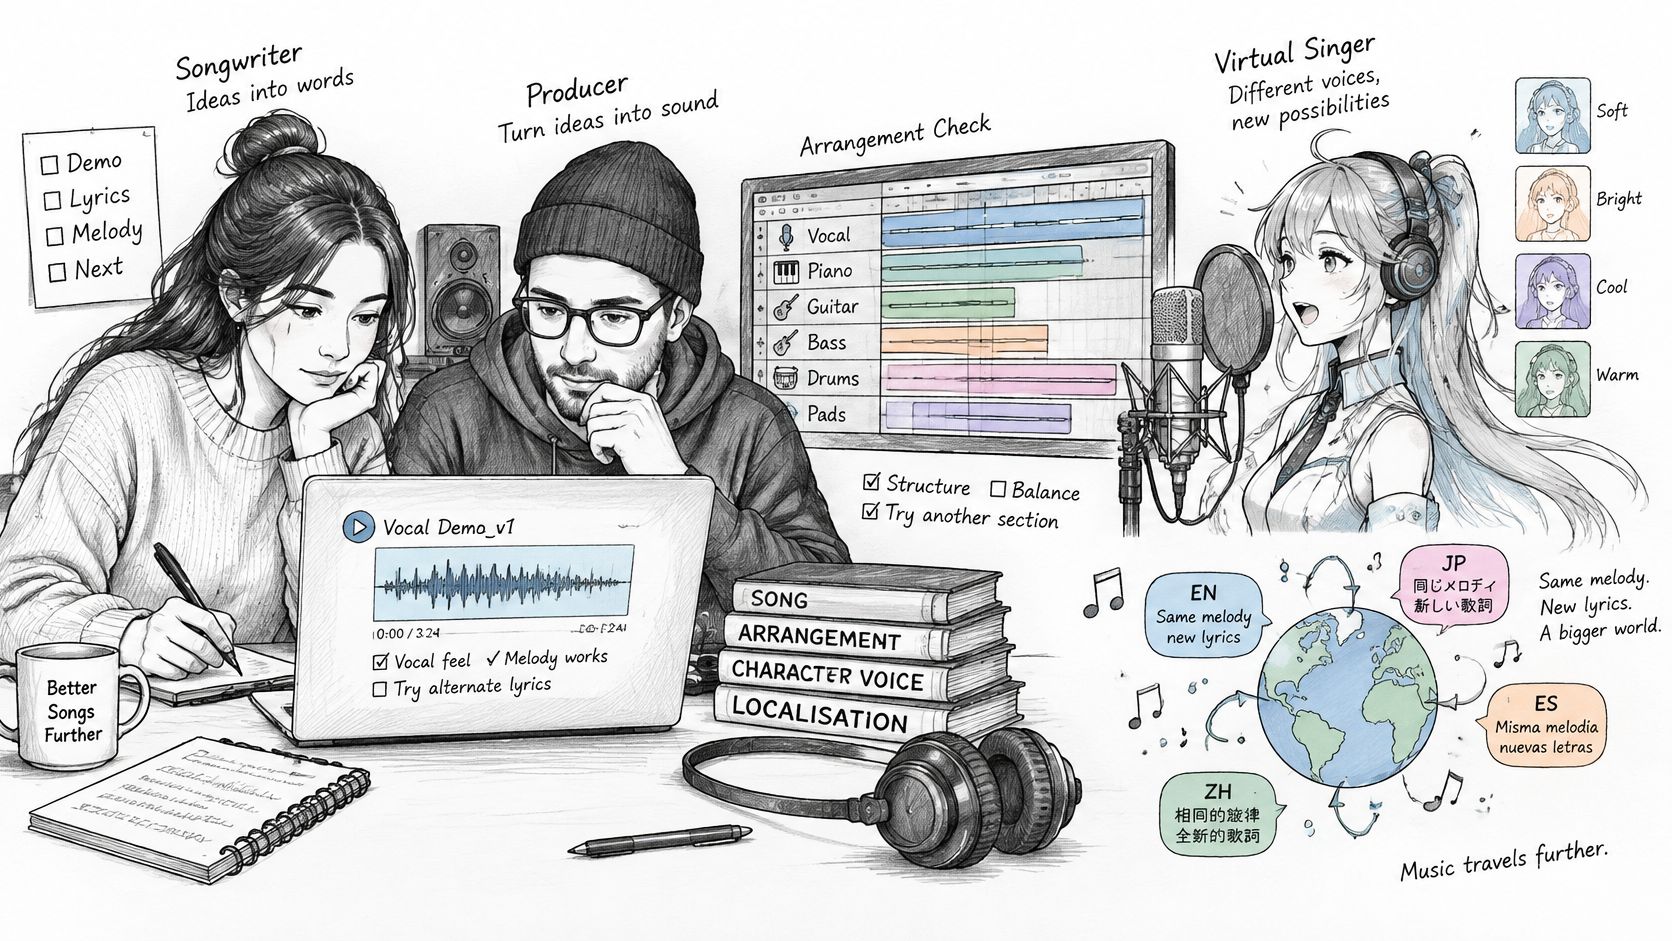
Un cantautore può usare il canto sintetico per verificare se un ritornello è cantabile prima di organizzare una sessione. Un produttore può provare un'armonia, mentre un team di gioco può testare come la canzone di un personaggio si adatta a una scena. Questi sono usi pratici perché la performance generata aiuta le persone a prendere una decisione di produzione concreta.
Le uscite incentrate sui personaggi e i prototipi di animazione possono anche utilizzare un'estetica vocale deliberatamente sintetica. Per la prototipazione audiovisiva, una guida alla creazione di un video musicale AI può aiutare a collegare il flusso di lavoro audio alla produzione visiva, ma la voce ha comunque bisogno di una propria revisione musicale.
Testa l'espressione, non solo le note corrette
La localizzazione è un esempio utile di come un compito apparentemente semplice diventi impegnativo. Mantenere la melodia cambiando lingua significa inserire nuove sillabe, schemi di accento e consonanti in una frase esistente. Una traduzione letterale potrebbe non essere adatta come testo cantato.
L'espressione culturalmente specifica aggiunge un altro livello. Il capitolo sul canto classico indiano descrive l'ornamentazione in relazione alla nota particolare, al raga, al cantante e al contesto musicale, dettagli che le misurazioni convenzionali di intonazione e intelligibilità potrebbero non cogliere.
Usa test mirati invece di chiedere solo se il risultato suona umano:
- Ornamentazione: Fai giudicare a un musicista familiare con la tradizione il movimento tra e intorno alle note.
- Code-switching: Inserisci un cambio di lingua all'interno di una frase e controlla accento, enfasi e continuità dell'identità vocale.
- Parole rare: Testa nomi e vocabolario lirico sconosciuto, quindi fai valutare la pronuncia da un madrelingua fluente.
- Fraseggio: Confronta dove il cantante generato respira, enfatizza una parola o rilascia una chiusura sostenuta.
Verifica l'origine separatamente dalla qualità
Una voce convincente non stabilisce chi l'ha eseguita. Il resoconto del National Institute of Justice sulla prima Singing Voice Deepfake Detection Challenge riporta 47 team partecipanti e un tasso di errore uguale del 1.65% per il team migliore nel contesto della sfida.
Questo risultato dimostra le prestazioni misurate del rilevatore in condizioni particolari, non un'autenticazione garantita di una pubblicazione arbitraria. Tratta il rilevamento come un controllo accanto a registri di provenienza, file sorgente e autorizzazione documentata.
Il canto sintetico è particolarmente utile per bozze, prototipi e voci di personaggi intenzionali. Una voce commerciale finale, specialmente su una pubblicazione importante, necessita di revisione umana per espressione musicale, accuratezza linguistica, identità e provenienza, piuttosto che di approvazione basata solo su una demo dal suono pulito.
Conferma i Diritti Prima di Costruire o Acquistare un Modello di Canto
Chi ha autorizzato la voce prima che venga addestrata, clonata o rilasciata? Una registrazione vocale può coinvolgere un interprete, un proprietario della registrazione, un paroliere e un compositore. Il permesso relativo a un contributo non risolve automaticamente gli altri.
L'articolo di AI & Society sulla governance dei dati di canto avverte che una licenza Creative Commons standard potrebbe non proteggere adeguatamente i contributori di dati di canto, perché le registrazioni possono contenere sia la voce di un interprete sia una canzone protetta da copyright. Distingue inoltre le regole statunitensi sul fair use dall'eccezione UE per il text-and-data-mining, piuttosto che trattarle come permessi interscambiabili.
Metti per iscritto gli usi consentiti
Usa una checklist dei diritti prima di trasferire registrazioni o integrare un modello:
- Identifica i diritti pertinenti. Documenta i permessi relativi alle registrazioni del cantante, ai testi, alla composizione, all'immagine e alla prevista pubblicazione commerciale. Registra chi può autorizzare ogni uso, invece di presumere che la persona che fornisce il file controlli tutto.
- Specifica le attività del modello. Indica se l'accordo consente il training, il fine-tuning, il voice cloning, la ridistribuzione e l'uso commerciale a valle. Una licenza per pubblicare una traccia audio non dovrebbe diventare un permesso per costruire un modello vocale riutilizzabile.
- Leggi i termini della licenza. Non fare affidamento solo su un'etichetta Creative Commons. Verifica se i termini riguardano il contributo dell'interprete e la canzone sottostante.
- Verifica la giurisdizione applicabile. Fai valutare da un consulente qualificato le regole pertinenti alle registrazioni, ai contributori e al deployment. Non trapiantare un'eccezione da un altro sistema legale nel tuo accordo.
- Pianifica cosa succede dopo l'addestramento. Definisci le procedure di revoca, la rimozione del modello, l'attribuzione e la condivisione dei ricavi. Specifica chi gestisce le richieste e quali rimedi sono tecnicamente e contrattualmente disponibili.
Mantieni le prove con le risorse di produzione
Mantieni un registro dei permessi insieme al dataset o al progetto. Includi la versione dell'accordo, gli usi consentiti, gli identificatori della registrazione sorgente e qualsiasi restrizione sulla distribuzione. Questo rende più facile distinguere un input autorizzato da un file che è semplicemente arrivato in una cartella condivisa.
La disponibilità pubblica non è prova di consenso o proprietà. Né una promessa di rimuovere una registrazione dovrebbe essere confusa con una dimostrata capacità di rimuovere la sua influenza da un modello già addestrato.
Prima di costruire o acquistare un modello di canto, ottieni termini scritti che coprano ogni diritto pertinente, attività consentita e obbligo post-addestramento.
MartLLM è un'API per modelli di testo, immagine, video, musica e voce. Se stai costruendo un workflow di produzione legato al canto, visita MartLLM per esplorare gli elenchi dei modelli e confrontare i loro input documentati con i tuoi requisiti per il controllo dello spartito, l'output audio e le attività multimediali correlate.