Zangstem Synthese: Hoe het werkt en waar het tekortschiet
Leer hoe zangstem synthese songteksten en noten omzet in gezongen audio, welke trainingsdata en vocoders beheersen, en waar het nog steeds tekortschiet.
Je hebt een melodie geschreven, de songtekst erop aangepast en een synthetische zanger geladen. De eerste weergave is bemoedigend, totdat een woord voorbijflitst, een aangehouden noot metaalachtig wordt en het refrein vreemd uitdrukkingsloos klinkt. Die problemen hoeven niet per se dezelfde oorzaak te hebben. Begrijpen waar elk probleem de signaalketen binnengaat, maakt het oplossen van de zang veel minder giswerk.
Inhoudsopgave
- Wat Zangstem Synthese Is en Waar Het Vandaan Komt
- Hoe een Zangstem Synthese Systeem een Partituur Omzet in Geluid
- Waarom Trainingsdata Bepaalt Hoe Goed een Zangstem Klinkt
- Akoestische Modellen en Vocoders Bepalen Waar Kwaliteit Wordt Gewonnen
- Hoe een Zangstem Synthese Systeem te Beoordelen
- Praktische Toepassingen, Beperkingen en Culturele Knelpunten
- Bevestig Rechten Voordat U een Zangmodel Bouwt of Koopt
Wat Zangstem Synthese Is en Hoe Het Ontstond
Zangstem synthese (SVS) genereert gezongen audio uit songteksten, een reeks noten met toonhoogtes en duur, en, in veel systemen, een geselecteerde zangeridentiteit. Stel je voor dat je een songwriter bent met een afgewerkte melodie, maar geen zanger beschikbaar. Je voert de noten en woorden in om te horen hoe de vocale lijn in je arrangement past.
Dit is niet zomaar spraaksynthese met een muzikale begeleidingstrack. Een gesproken zin heeft geloofwaardige frasering nodig, maar een gezongen zin moet ook muzikale toonhoogtes volgen, klinkers aanhouden en medeklinkers rond de maat plaatsen. Een lettergreep die acceptabel is in een gesprek, kan ongemakkelijk klinken wanneer deze over een lange noot wordt uitgerekt.
Van opgenomen fragmenten naar geleerde stemmen
Vroege benaderingen gebruikten regels en signaalverwerking, gevolgd door systemen die opgenomen vocale eenheden samenstelden. Statistische en neurale benaderingen leerden vervolgens relaties tussen songteksten, muzikale instructies en akoestische output, in plaats van alleen te vertrouwen op het aan elkaar plakken van fragmenten.
Volgens Yamaha's verslag van de ontwikkeling van VOCALOID begon het project in februari 2000 via de DAISY-samenwerking met Universitat Pompeu Fabra in Barcelona, en verscheen het eerste commerciële product in 2004. De ontwikkelaars hadden een speciale zangdatabase nodig omdat gewone computerinvoer en conventionele spraaktechnologie zang niet adequaat konden reproduceren.
Virtuele zangers zoals Hatsune Miku hielpen ook om synthetische zang om te vormen tot een karaktergericht creatief medium. De stem kon deel worden van een artistieke identiteit, niet alleen een vervangende track in een opnamesessie.
Nuttig onderscheid: Het genereren van een muzikale uitvoering en het noot voor noot controleren van een gezongen melodie zijn niet dezelfde vereisten.
Wanneer je een lijst met muziekgeneratiemodellen bekijkt, controleer dan de invoerbediening in plaats van aan te nemen dat elke muziekhulpmiddel een vocale partituur accepteert. Voor een bruikbaar zangsysteem moet je de signaalketen begrijpen, de kwaliteitsgrenzen ervan herkennen en vaststellen hoe de stemmen kunnen worden geëvalueerd en gelicentieerd.
Hoe een Zangstem Synthese Systeem een Partituur Omzet in Geluid
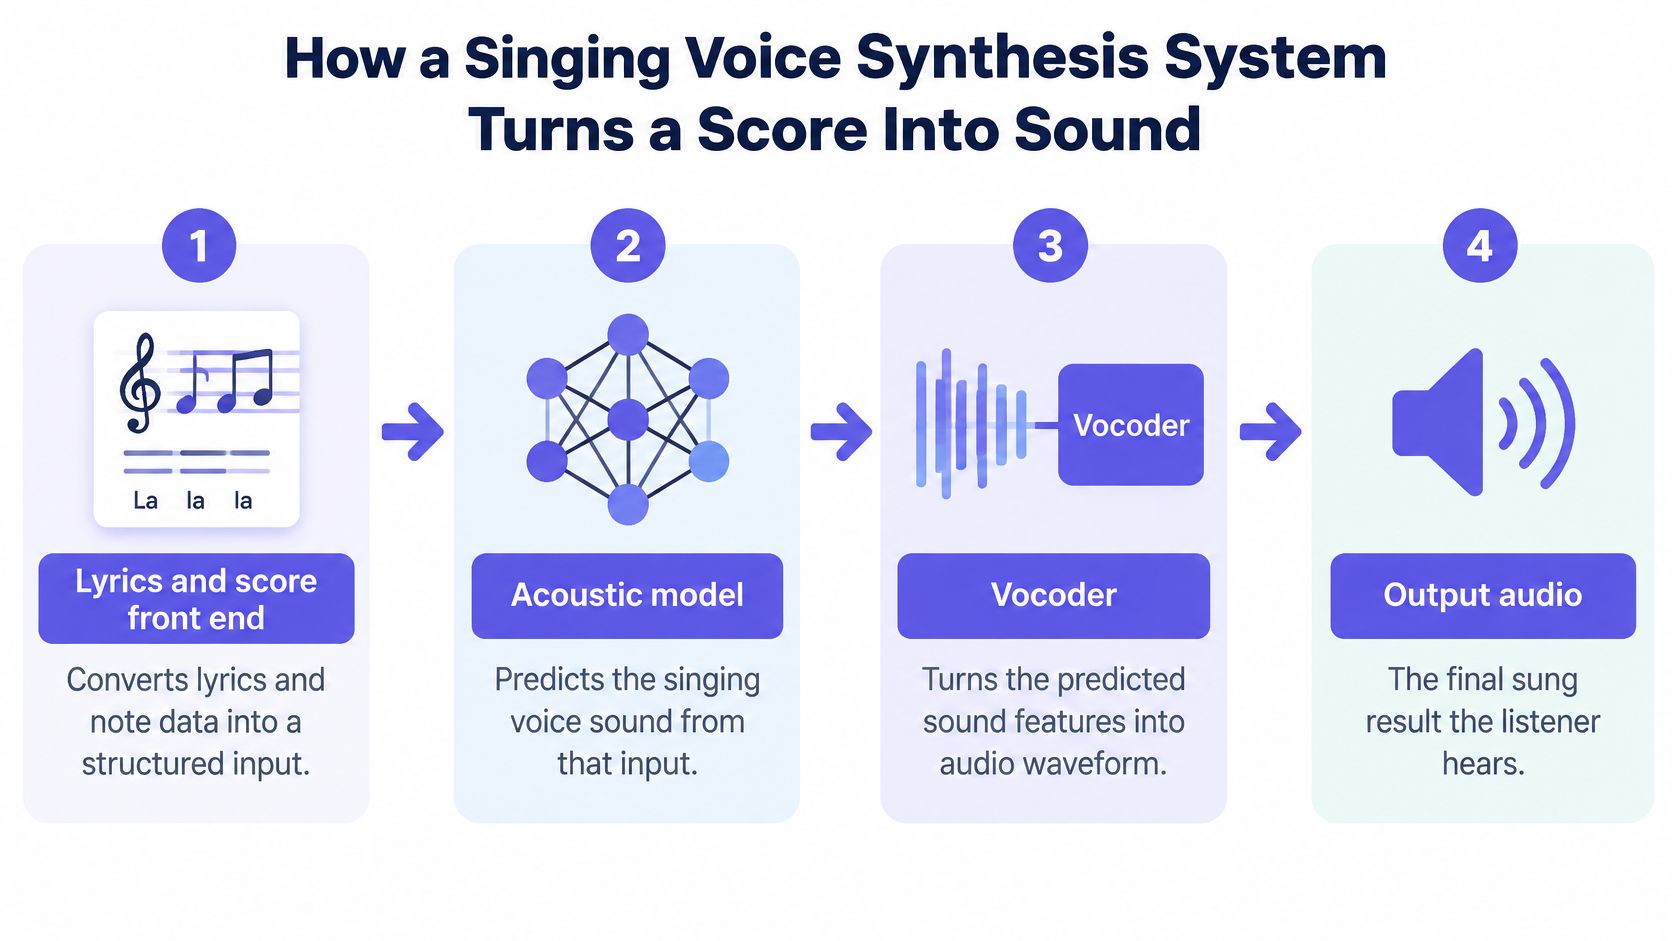
Wat gaat erin, en wat komt eruit? In een partituurgestuurde workflow is de invoer een muzikale instructieset. De uitvoer is een golfvorm die je kunt afspelen, bewerken en mixen.
Pijplijnfasen in een zangstem synthese systeem
| Fase | Invoer | Uitvoer | Wat het regelt |
|---|---|---|---|
| Front-end voor tekst en partituur | Tekst, toonhoogte en nootduur | Fonemenreeks met timing | Welk geluid op welke tel wordt gezongen |
| Duur- en toonhoogtemodel | Fonemen en partituur | Timing en toonhoogtecurve op frameniveau | Vibrato, nootaanzetten en toonhoogteprecisie |
| Akoestisch model | Fonemen, timing, toonhoogte en zangeridentiteit | Mel-spectrogram | Klankkleur, klinkervorm en articulatie |
| Vocoder | Mel-spectrogram | Audiogolfvorm | Helderheid, ademgeluid en hoorbare artefacten |
De illustratie toont de bredere stroom, waarbij beslissingen over duur en toonhoogte zijn opgenomen in het voorspellingsproces.
Woorden en noten omzetten in een uitvoering
De front-end splitst teksten op in fonemen, de individuele spraakklanken binnen woorden, en koppelt deze aan noten. Een geschreven lettergreep is geen enkel ononderbroken geluid. In stay hebben de beginmedeklinkers een andere behandeling nodig dan de klinker die de aangehouden toonhoogte draagt.
Als het systeem te veel tijd toewijst aan de medeklinkers, kan de klinker te laat komen. Als het de klinker verkort om te compenseren, klinkt het woord gehaast, zelfs als de noot op tijd eindigt. Begin met uitspraak en fonemenplaatsing wanneer een tekst ritmisch verkeerd aanvoelt.
Het duur- en toonhoogtemodel bepaalt hoe die geluiden zich in de tijd ontvouwen. De noot specificeert een doeltoonhoogte, maar de uitgevoerde toonhoogtecurve kan een zachte benadering, een stabiel centrum en vibrato naar het einde toe omvatten. Een perfect vlakke curve kan rigide klinken; een overdreven overgang kan klinken als een onbedoelde scoop.
Sommige tools accepteren expliciete nootgegevens, terwijl andere een melodie genereren of afleiden uit minder beperkte invoer, inclusief teksten. Dat verschil bepaalt of je een bepaalde noot direct kunt repareren of een andere uitvoering moet aanvragen.
Een uitvoeringsbeschrijving omzetten in audio
Het akoestisch model voorspelt een representatie zoals een mel-spectrogram, dat beschrijft hoe geluidsenergie over frequentie en tijd is verdeeld. Zie het als een veranderende kaart van de stemklank, niet als een audiobestand dat je al kunt horen.
Slecht gedefinieerde spectrale kenmerken kunnen doffe klinkers, vage medeklinkers of een onstabiele vocale identiteit produceren. Maar dofheid alleen bewijst niet dat het akoestisch model verantwoordelijk is. De uiteindelijke golfvormgenerator kan ook nuttige details verdoezelen.
De vocoder converteert de voorspelde representatie naar geluidssamples. Zoemen, korreligheid of metaalachtige texturen kunnen hier ontstaan, vooral bij blootgestelde aangehouden klinkers.
Identificeer vóór het bewerken of de tool noten accepteert en welke controles de vermoedelijke fase beïnvloeden. Probeer een misplaatste medeklinker niet te corrigeren met egalisatie, of een ruwe golfvorm door een correct uitgesproken tekst te herschrijven.
Waarom trainingsdata bepaalt hoe goed een zangstem klinkt
Zang opnemen is maar een deel van het bouwen van een bruikbare dataset. Ontwikkelaars hebben ook betrouwbare songteksten, nootuitlijning, fonemtiming en annotaties nodig die bedoelde expressie onderscheiden van fouten. Zonder die context kan een model een akoestische gebeurtenis leren zonder te leren wanneer die thuishoort.
De corpusvergelijking in het overzicht van zangdatasets illustreert de beperkte omvang en dekking qua zangers van verschillende invloedrijke bronnen, hieronder samengevat.
Zangdatasets naar omvang en dekking
| Corpus | Zangers | Uur | Wat het omvat |
|---|---|---|---|
| VocalSet | 20 | Ongeveer 10.1 | Zangtechnieken, klinkers en gevarieerde toonhoogtes, geen volledige nummers |
| NUS-48E | 12 | Ongeveer 2.8 | Klein corpus met een beperkt aantal zangers |
| MIR-1K | 19 | Ongeveer 2.2 | Klein corpus met een beperkt aantal zangers |
| CSD | 1 | Ongeveer 4.9 | 100 nummers in twee talen van één zanger |
| SingNet | Niet gespecificeerd in de aangehaalde samenvatting | Ongeveer 3,000 | In-the-wild zang en sample packs in verschillende talen en stijlen |
De SingNet preprint meldt 2,629 uur in-the-wild zang en 321 uur uit sample packs, goed voor ongeveer 3,000 uur in totaal. Dat is een flinke uitbreiding van het beschikbare materiaal, maar de omvang van een verzameling is geen garantie voor muzikale dekking.
Dekking is net zo belangrijk als de duur
De focus van VocalSet op technieken, klinkers en toonhoogtes maakt het nuttig voor het bestuderen van zanggedrag. Daarmee is het nog niet uitwisselbaar met een corpus van volledige, expressief gefraseerde nummers. Op dezelfde manier kan een verzameling met één zanger consistentie bieden zonder aan te tonen dat een systeem generaliseert over verschillende zangidentiteiten.
Overfitting betekent dat een model te afhankelijk wordt van patronen in zijn trainingsmateriaal. In de praktijk kan dat bij het luisteren betekenen: een overtuigende, bekende klinker maar een onhandige, onbekende uitspraak, of een sterk resultaat in een vertegenwoordigde stijl en een weinig overtuigend resultaat elders.
Kijk bij modelselectie naar:
- Dekking van zangers: Zoek naar gedocumenteerde stembereiken en identiteiten, niet alleen naar een totale opnameduur.
- Taaldekking: Controleer of de taal van je songteksten en je uitspraakconventies zijn vertegenwoordigd.
- Muzikale dekking: Onderscheid losse oefeningen van volledige frases, overgangen en aangehouden expressie.
- Kwaliteit van annotaties: Zoek naar een uitleg over hoe songteksten en noten op de opnamen zijn afgestemd.
De nuttige vraag is niet alleen hoeveel audio een ontwikkelaar heeft verzameld. Het is hoe goed het gedocumenteerde materiaal overeenkomt met de uitvoering die je nodig hebt. Ontbrekende documentatie beperkt met hoeveel vertrouwen je een kwaliteitsclaim kunt toepassen buiten een gepolijste demonstratie.
Akoestische Modellen en Vocoders Bepalen Waar Kwaliteit Wordt Gewonnen
De golfvormgenerator kan de waargenomen zangkwaliteit aanzienlijk veranderen, zelfs wanneer de upstream predictor hetzelfde blijft. Dat maakt de vocoder een technische keuze, niet zomaar een exportstap.
In een gecontroleerde studie naar neurale zangsynthese presteerden op CNN gebaseerde akoestische modellen beter dan overeenkomstige feed-forward netwerken in natuurlijkheidstests, en het vervangen van de traditionele MLSA vocoder door WaveNet verbeterde beide modelfamilies. De studie trainde op 55 Japanse kinderliedjes en 55 J-pop nummers, hield vijf J-pop nummers achter en gebruikte gemiddelde meningsscores op een vijfpuntsschaal van 15 luisteraars die willekeurig geselecteerde testzinnen evalueerden. Deze resultaten ondersteunen een gecontroleerde vergelijking, geen universele rangschikking voor zangers, talen of genres.
Scheid voorspellingsfouten van renderingfouten
Een akoestisch model kan de verkeerde vocale structuur voorspellen. Een vocoder kan een redelijke voorspelling slecht renderen. Beide storingen kunnen kunstmatig klinken, maar het vervangen van dezelfde component zal beide niet oplossen.
Voor een modulair systeem, test de vocoder met behulp van akoestische features die zijn geëxtraheerd uit een schone referentieopname. Dit is een resynthesetest: je controleert hoe goed de golfvormfase informatie reconstrueert die al bestaat, in plaats van de akoestische predictor te vragen deze uit te vinden.
Synthetiseer vervolgens vanuit de score. Als de referentie-resynthese duidelijk is, maar de score-gestuurde output modderig klinkt, onderzoek dan de voorspelde features, alignment en pitch conditioning. Als de referentiereconstructie al korrelig klinkt, pak dan eerst de vocoder of feature-compatibiliteit aan.
Vervang het hele model niet voordat je hebt gecontroleerd of het defect al vóór de golfvormgeneratie bestaat.
Dit onderscheid is ook belangrijk bij het evalueren van aangrenzende stemtools. Een lijst met tekst-naar-spraak modellen beschrijft een andere taak; verstaanbare gesproken output alleen garandeert geen kwaliteit van aangehouden noten of score control.
Kies getrouwheid en latency voor de daadwerkelijke taak
WaveNet-achtige autoregressieve vocoders genereren audio sequentieel, wat de latency kan verhogen. Snellere alternatieven, waaronder LPCNet, kunnen geschikter zijn wanneer responsieve weergave belangrijk is.
Voor offline rendering accepteer je mogelijk een langere wachttijd om vocale details te behouden. Voor interactieve compositie geef je misschien de voorkeur aan een snelle preview en reserveer je een hogere kwaliteit render voor beoordeling.
Meet zowel de generatietijd als de artefacten die je kunt horen binnen je beoogde workflow. Een mooie geïsoleerde render is minder nuttig als deze elke kleine melodie-bewerking onderbreekt, terwijl een responsieve preview niet moet worden verward met de beste uiteindelijke output die het systeem kan produceren.
Hoe een zangstem-synthesesysteem te beoordelen
Een stem kan natuurlijk klinken terwijl de toonhoogte afwijkt, of de noten nauwkeurig volgen terwijl ze dun klinkt. Geen enkele kwaliteitsscore beschrijft de hele prestatie. Je hebt luisteroordelen nodig naast metingen van het gegenereerde signaal.
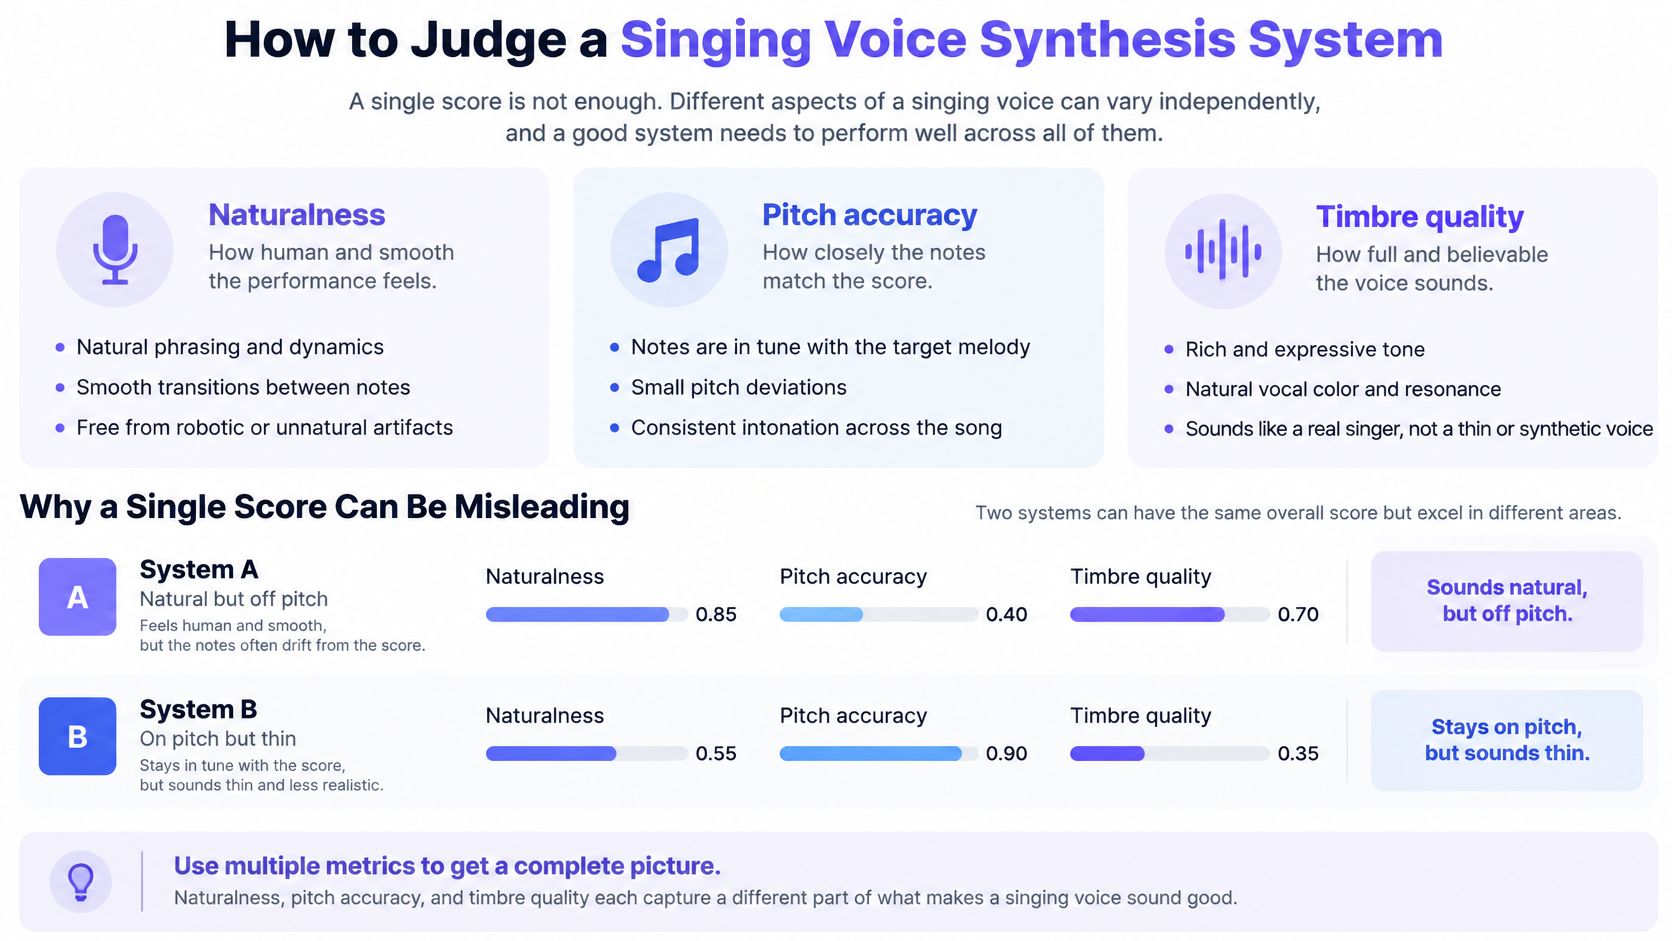
Het WeSinger 2 artikel gebruikt MOS, F0 root-mean-square error, en mel-spectrogram distortie om complementaire aspecten van zangkwaliteit te onderzoeken. De multi-singer conditionele adversariële training verbetert de MOS ten opzichte van het eerdere WeSinger-systeem op Opencpop en Data-L, maar vergelijkende winsten verschillen per dataset, wat het belang van zanger- en corpuscondities onderstreept.
Metrics voor het beoordelen van zangstem-synthesekwaliteit
| Metric | Wat het detecteert | Wat het mist |
|---|---|---|
| MOS | Algemeen waargenomen kwaliteit door luisteraars | Kan toonhoogteafwijking en zangerspecifieke details verbergen |
| F0 RMSE | Toonhoogte, intonatie en stemmingsfout | Ademruis, uitspraak en klankkleur |
| MSD | Spectrale mismatch gekoppeld aan klankkleur en articulatie | Of een frase expressief of stijlvol aanvoelt |
Bekijk de metingen samen
MOS, of mean opinion score, vat luisterbeoordelingen samen. Het is nuttig om te vragen of mensen het algehele resultaat prefereren, maar de interpretatie hangt af van wat ze hoorden en wat ze moesten beoordelen.
F0 RMSE meet fouten in de grondfrequentie, de akoestische grootheid die geassocieerd wordt met waargenomen toonhoogte. Het helpt stemmingsproblemen te onthullen, maar het stelt niet vast dat de woorden verstaanbaar zijn of de vocale klank geloofwaardig is.
MSD vergelijkt spectrale representaties. Het kan verschillen blootleggen die verband houden met articulatie en klankkleur, maar het matchen van een referentiespectrogram is niet hetzelfde als het maken van een overtuigende artistieke keuze.
Luistercheck: Beluister de zangpartij alleen voordat je deze beoordeelt binnen een dichte mix. Begeleiding kan zwakke medeklinkers en onstabiele noot-eindes moeilijker te detecteren maken.
Stel een evaluatieset samen met onbekende nummers en, indien het systeem dit ondersteunt, niet-getrainde zangers. Voeg aangehouden klinkers, medeklinkerrijke teksten, registerveranderingen en frasen toe die een bewuste expressieve timing vereisen.
Rapporteer de metrics samen, luister dan specifiek naar ademruis, uitspraak en vocale identiteit. Als een leverancier alleen een headline natuurlijkheidsscore aanbiedt, behandel dit dan als bewijs over die specifieke luistertest, niet als bewijs dat jouw tekst, zanger en arrangement even goed zullen werken.
Praktische Toepassingen, Beperkingen en Culturele Verschillen
Een songwriter kan synthetische zang gebruiken om te controleren of een refrein zingbaar is voordat een sessie wordt georganiseerd. Een producer kan een harmonie uitproberen, terwijl een gameteam kan testen hoe het lied van een personage in een scène past. Dit zijn praktische toepassingen omdat de gegenereerde uitvoering mensen helpt een concrete productiebeslissing te nemen.
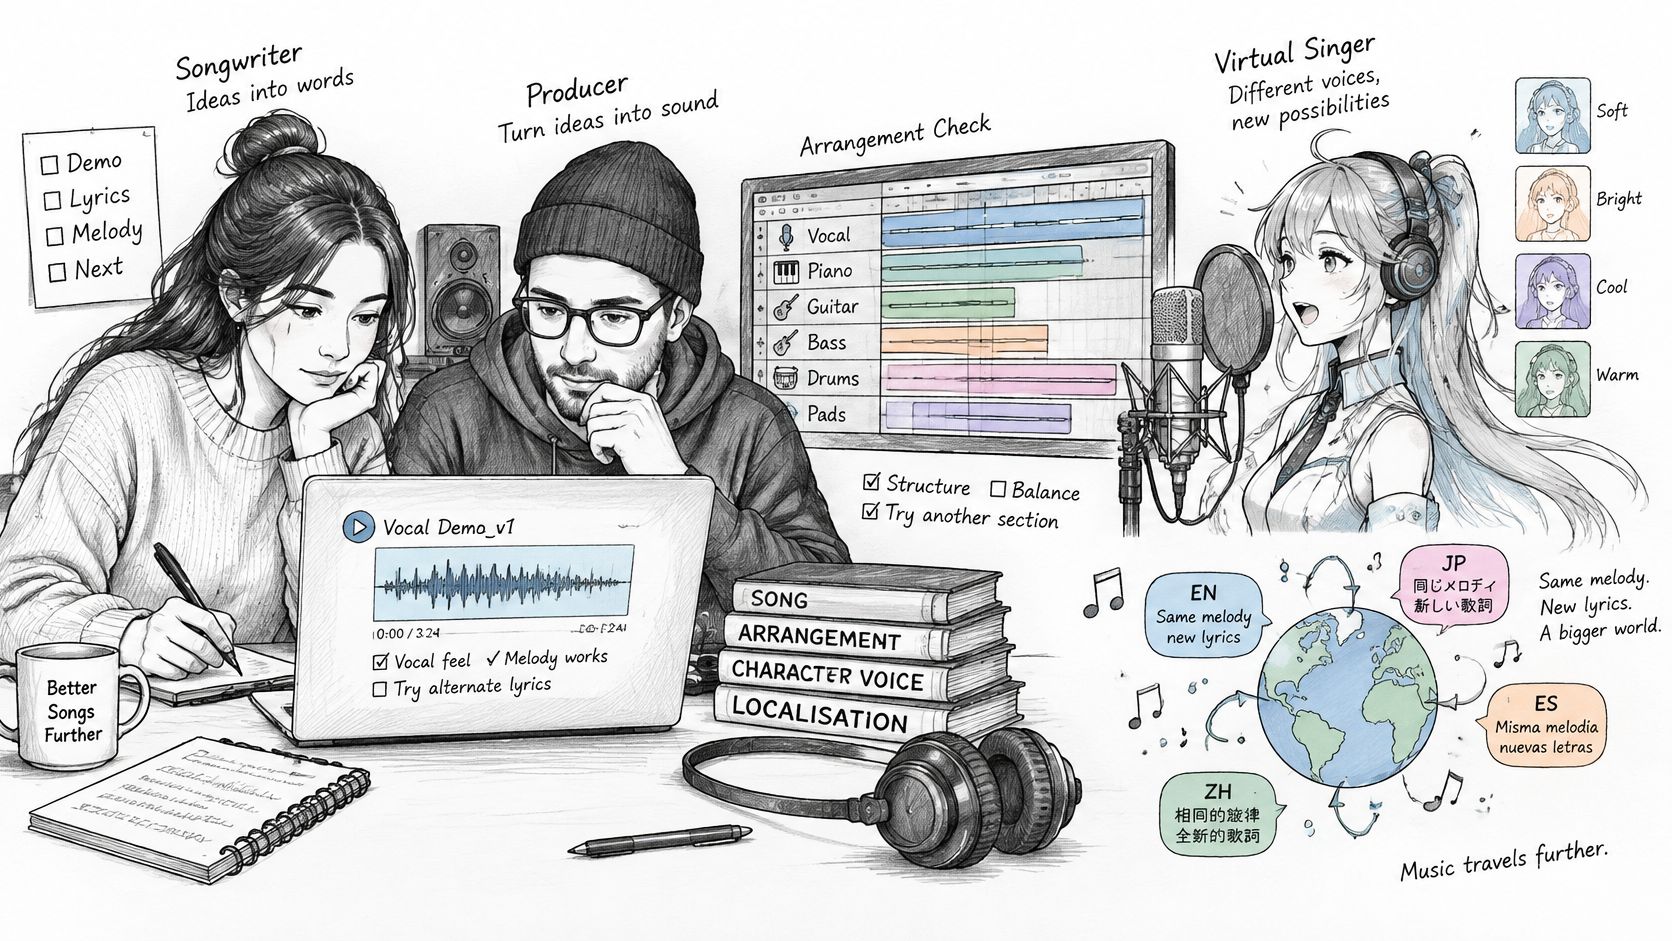
Personagegerichte releases en animatieprototypes kunnen ook een bewust synthetische vocale esthetiek gebruiken. Voor audiovisuele prototyping kan een gids voor het maken van een AI-muziekvideo helpen de audioworkflow te verbinden met visuele productie, maar de zang heeft nog steeds een eigen muzikale beoordeling nodig.
Test expressie, niet alleen correcte noten
Lokalisatie is een nuttig voorbeeld van hoe een ogenschijnlijk eenvoudige taak veeleisend wordt. Het behouden van de melodie bij het wisselen van talen betekent het inpassen van nieuwe lettergrepen, klemtoonpatronen en medeklinkers in een bestaande frase. Een letterlijke vertaling kan ongeschikt zijn als gezongen tekst.
Cultureel specifieke expressie voegt een extra laag toe. Het hoofdstuk over Indiase klassieke zang beschrijft versiering in relatie tot de specifieke noot, raga, zanger en muzikale context, details die conventionele toonhoogte- en verstaanbaarheidsmetingen kunnen missen.
Gebruik gerichte tests in plaats van alleen te vragen of het resultaat menselijk klinkt:
- Versiering: Laat een muzikant die bekend is met de traditie de beweging tussen en rond noten beoordelen.
- Code-switching: Plaats een taalwisseling binnen een frase en controleer accent, klemtoon en continuïteit van vocale identiteit.
- Zeldzame woorden: Test namen en onbekende songtekstvocabulaire, en laat vervolgens een vloeiende spreker de uitspraak beoordelen.
- Frasering: Vergelijk waar de gegenereerde zanger ademt, een woord benadrukt of een aangehouden einde loslaat.
Verifieer herkomst los van kwaliteit
Een overtuigende zangstem bewijst niet wie deze heeft uitgevoerd. Het verslag van het National Institute of Justice over de eerste Singing Voice Deepfake Detection Challenge meldt 47 deelnemende teams en een topteam equal-error rate van 1.65% in de uitdagingssetting.
Dat resultaat toont de gemeten detectorprestaties onder specifieke omstandigheden, niet gegarandeerde authenticatie van een willekeurige release. Behandel detectie als één controle naast herkomstgegevens, bronbestanden en gedocumenteerde autorisatie.
Synthetische zang is bijzonder nuttig voor concepten, prototypes en opzettelijke karakterstemmen. Een definitieve commerciële zang, vooral bij een grote release, heeft menselijke beoordeling nodig voor muzikale expressie, taalaccuraatheid, identiteit en herkomst, in plaats van goedkeuring gebaseerd op alleen een zuiver klinkende demo.
Bevestig Rechten Voordat Je Een Zingend Model Bouwt Of Koopt
Wie heeft de stem geautoriseerd voordat deze wordt getraind, gekloond of uitgebracht? Een vocale opname kan betrekking hebben op een uitvoerder, een eigenaar van de opname, een tekstschrijver en een componist. Toestemming voor één bijdrage regelt niet automatisch de andere.
Het AI & Society artikel over het beheer van zangdata waarschuwt dat een standaard Creative Commons-licentie zangdata-bijdragers mogelijk niet adequaat beschermt, omdat opnames zowel de stem van een uitvoerder als een auteursrechtelijk beschermd lied kunnen bevatten. Het onderscheidt ook Amerikaanse fair-use regels van de EU-uitzondering voor tekst- en datamining in plaats van ze als uitwisselbare toestemmingen te behandelen.
Leg de toegestane gebruiken op schrift vast
Gebruik een rechten-checklist voordat je opnames overdraagt of een model integreert:
- Identificeer de relevante rechten. Documenteer toestemmingen met betrekking tot de opnames van de zanger, teksten, compositie, gelijkenis en beoogde commerciële release. Leg vast wie elk gebruik kan autoriseren, in plaats van aan te nemen dat de persoon die het bestand levert alles beheert.
- Specificeer de modelactiviteiten. Vermeld of de overeenkomst training, fine-tuning, stemklonen, herdistributie en commercieel gebruik stroomafwaarts toestaat. Een licentie om een audiotrack te publiceren mag geen toestemming worden om een herbruikbaar stemmodel te bouwen.
- Lees de licentievoorwaarden. Vertrouw niet alleen op een Creative Commons-label. Controleer of de voorwaarden betrekking hebben op de bijdrage van de uitvoerder en het onderliggende lied.
- Controleer de toepasselijke jurisdictie. Laat gekwalificeerde juridische adviseurs de regels beoordelen die relevant zijn voor de opnames, bijdragers en implementatie. Transplanteer geen uitzondering van een ander rechtssysteem in je overeenkomst.
- Plan wat er gebeurt na de training. Definieer herroepingsprocedures, modelverwijdering, attributie en winstdeling. Specificeer wie verzoeken afhandelt en welke remedies technisch en contractueel beschikbaar zijn.
Bewaar bewijs bij de productie-assets
Houd een toestemmingsregister bij naast de dataset of het project. Vermeld de overeenkomstversie, toegestane gebruiken, identificatiegegevens van de bronopname en eventuele distributiebeperkingen. Dat maakt het gemakkelijker om een geautoriseerde invoer te onderscheiden van een bestand dat simpelweg in een gedeelde map terechtkwam.
Openbare beschikbaarheid is geen bewijs van toestemming of eigendom. Evenmin mag een belofte om een opname te verwijderen worden verward met een aantoonbaar vermogen om de invloed ervan uit een reeds getraind model te verwijderen.
Voordat je een zingend model bouwt of koopt, verkrijg schriftelijke voorwaarden die elk relevant recht, elke toegestane activiteit en elke verplichting na de training dekken.
MartLLM is een API voor tekst-, beeld-, video-, muziek- en spraakmodellen. Als je een zanggerelateerde productieworkflow bouwt, bezoek dan MartLLM om modeloverzichten te verkennen en hun gedocumenteerde inputs te vergelijken met jouw vereisten voor scorecontrole, audio-output en omliggende mediataken.