Gesangssynthese: Wie es funktioniert und wo es scheitert
Erfahren Sie, wie Gesangssynthese Liedtexte und Noten in gesungene Audiodaten umwandelt, was Trainingsdaten und Vocoder steuern und wo sie noch Schwächen aufweist.
Sie haben eine Melodie geschrieben, die Texte dazu angepasst und einen synthetischen Sänger geladen. Die erste Wiedergabe ist ermutigend, bis ein Wort vorbeihuscht, ein gehaltener Ton metallisch klingt und der Refrain seltsam ausdruckslos wirkt. Diese Probleme haben nicht unbedingt dieselbe Ursache. Zu verstehen, wo jedes Problem in die Signalkette eintritt, macht die Korrektur des Gesangs viel weniger zu einem Ratespiel.
Inhaltsverzeichnis
- Was Gesangssynthese ist und woher sie kommt
- Wie ein Gesangssynthesesystem eine Partitur in Klang verwandelt
- Warum Trainingsdaten entscheiden, wie gut eine Gesangsstimme klingt
- Akustische Modelle und Vocoder entscheiden, wo Qualität gewonnen wird
- Wie man ein Gesangssynthesesystem beurteilt
- Praktische Anwendungen, Grenzen und kulturelle Lücken
- Rechte bestätigen, bevor Sie ein Gesangsmodell erstellen oder kaufen
Was Gesangsstimmen-Synthese ist und woher sie kommt
Gesangsstimmen-Synthese (SVS) erzeugt gesungenes Audio aus Texten, einer Abfolge von Noten mit Tonhöhen und Dauern und, in vielen Systemen, einer ausgewählten Sängeridentität. Stellen Sie sich vor, Sie sind ein Songwriter mit einer fertigen Melodie, aber kein Sänger ist verfügbar. Sie geben die Noten und Worte ein, um zu hören, wie die Gesangslinie zu Ihrem Arrangement passt.
Dies ist nicht nur Sprachsynthese mit musikalischer Begleitung. Ein gesprochener Satz benötigt eine glaubwürdige Phrasierung, aber ein gesungener Satz muss auch musikalischen Tonhöhen folgen, Vokale halten und Konsonanten um den Beat herum platzieren. Eine Silbe, die in einem Gespräch akzeptabel ist, kann unbeholfen klingen, wenn sie über eine lange Note gedehnt wird.
Von aufgenommenen Fragmenten zu gelernten Stimmen
Frühe Ansätze verwendeten Regeln und Signalverarbeitung, gefolgt von Systemen, die aufgenommene Gesangseinheiten zusammensetzten. Statistische und neuronale Ansätze lernten anschließend Beziehungen zwischen Texten, musikalischen Anweisungen und akustischer Ausgabe, anstatt sich nur auf das Zusammenfügen von Fragmenten zu verlassen.
Laut Yamahas Bericht über die Entwicklung von VOCALOID begann das Projekt im Februar 2000 durch die DAISY-Zusammenarbeit mit der Universitat Pompeu Fabra in Barcelona, und das erste kommerzielle Produkt erschien im Jahr 2004. Die Entwickler benötigten eine spezielle Gesangsdatenbank, da gewöhnliche Computereingabe und herkömmliche Sprachtechnologie Gesang nicht adäquat reproduzieren konnten.
Virtuelle Sänger wie Hatsune Miku trugen auch dazu bei, synthetischen Gesang zu einem charakterzentrierten kreativen Medium zu machen. Die Stimme konnte Teil einer künstlerischen Identität werden, nicht nur ein Ersatz-Track in einer Aufnahmesitzung.
Nützliche Unterscheidung: Eine musikalische Darbietung zu generieren und eine gesungene Melodie Note für Note zu steuern, sind nicht dieselbe Anforderung.
Wenn Sie eine Liste von Musikgenerierungsmodellen durchsuchen, prüfen Sie die Eingabesteuerungen, anstatt davon auszugehen, dass jedes Musiktool eine Gesangspartitur akzeptiert. Für ein nutzbares Gesangssystem müssen Sie dessen Signalkette verstehen, seine Qualitätsgrenzen erkennen und festlegen, wie seine Stimmen bewertet und lizenziert werden können.
Wie ein Gesangssynthesesystem eine Partitur in Klang verwandelt
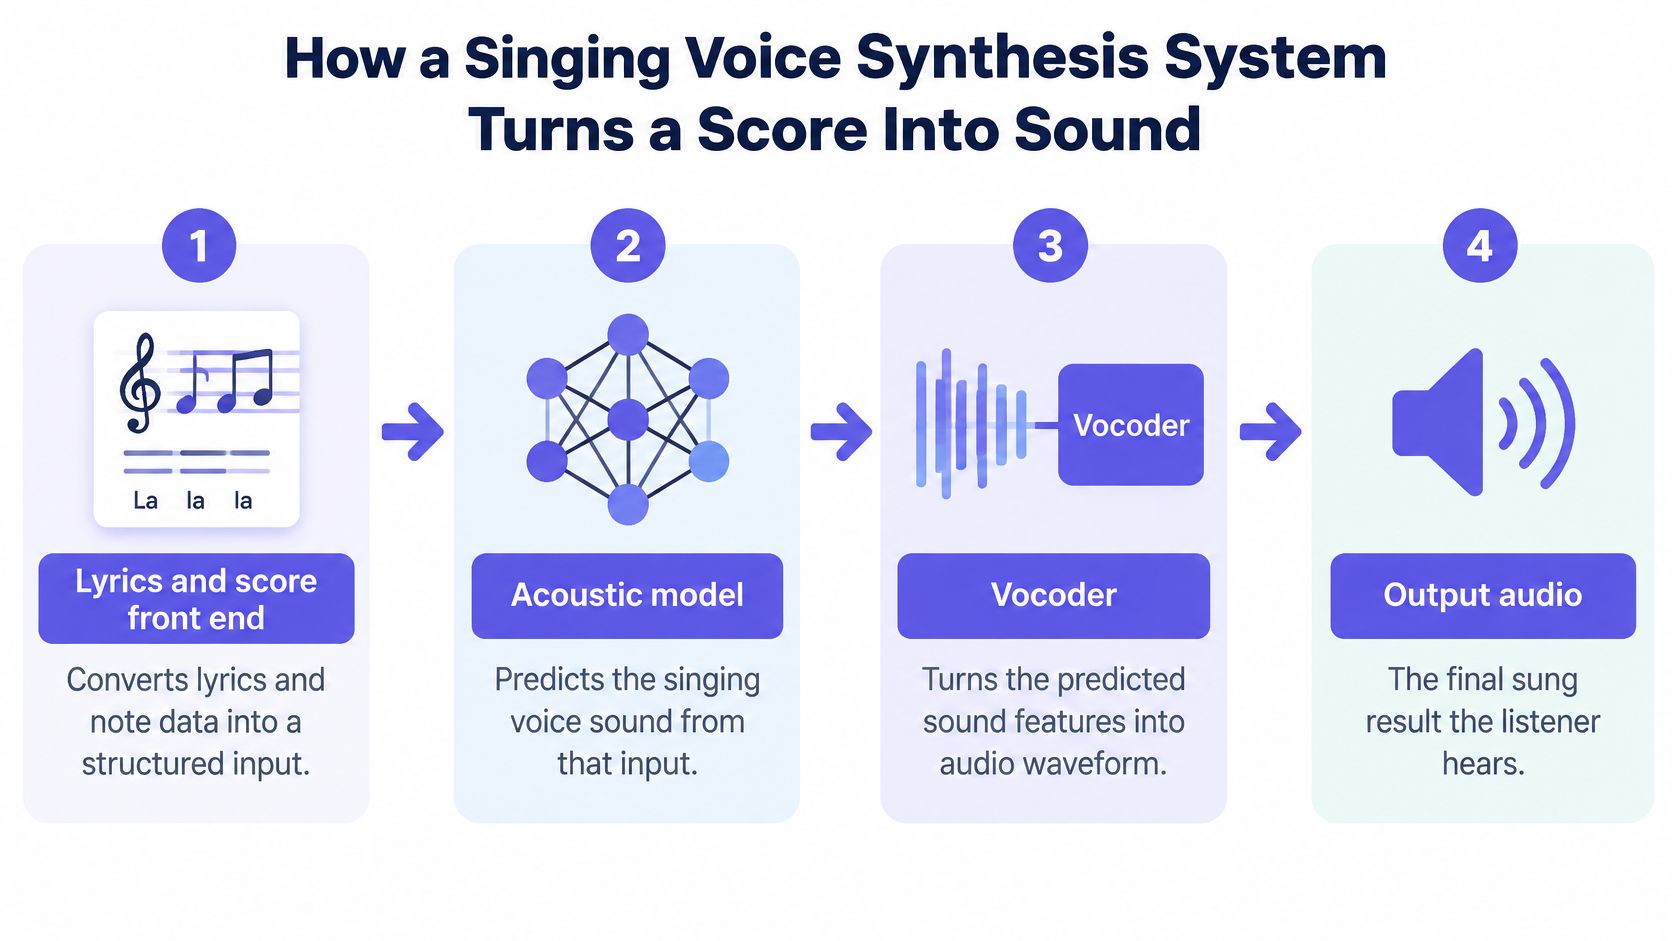
Was geht hinein, und was kommt heraus? In einem partiturgesteuerten Workflow ist der Input ein musikalischer Anweisungssatz. Der Output ist eine Wellenform, die Sie abspielen, bearbeiten und mischen können.
Phasen der Pipeline in einem Gesangssynthesesystem
| Phase | Input | Output | Was es steuert |
|---|---|---|---|
| Front-End für Liedtext und Partitur | Liedtexte, Tonhöhe und Notendauer | Phonemsequenz mit Timing | Welcher Klang auf welchem Schlag gesungen wird |
| Dauer- und Tonhöhenmodell | Phoneme und Partitur | Timing auf Frame-Ebene und Tonhöhenkurve | Vibrato, Notenanschläge und Tonhöhengenauigkeit |
| Akustisches Modell | Phoneme, Timing, Tonhöhe und Sängeridentität | Mel-Spektrogramm | Klangfarbe, Vokalform und Artikulation |
| Vocoder | Mel-Spektrogramm | Audio-Wellenform | Klarheit, Behauchtheit und hörbare Artefakte |
Die Abbildung zeigt den umfassenderen Ablauf, wobei Dauer- und Tonhöhenentscheidungen in den Vorhersageprozess integriert sind.
Wörter und Noten in eine Performance verwandeln
Das Front-End zerlegt Liedtexte in Phoneme, die einzelnen Sprachlaute innerhalb von Wörtern, und ordnet sie Noten zu. Eine geschriebene Silbe ist kein einzelner, ununterbrochener Klang. In stay benötigen die einleitenden Konsonanten eine andere Behandlung als der Vokal, der die gehaltene Tonhöhe trägt.
Wenn das System den Konsonanten zu viel Zeit zuweist, kann der Vokal zu spät kommen. Wenn es den Vokal zur Kompensation kürzt, klingt das Wort gehetzt, obwohl die Note pünktlich endet. Beginnen Sie mit der Aussprache und der Phonemplatzierung, wenn ein Liedtext rhythmisch falsch klingt.
Das Dauer- und Tonhöhenmodell entscheidet, wie sich diese Klänge im Laufe der Zeit entfalten. Die Note gibt eine Zieltonhöhe vor, aber die ausgeführte Tonhöhenkurve kann einen sanften Ansatz, ein stabiles Zentrum und Vibrato zum Ende hin umfassen. Eine perfekt flache Kurve kann starr klingen; ein übertriebener Übergang kann wie ein unbeabsichtigtes Glissando klingen.
Einige Tools akzeptieren explizite Notendaten, während andere eine Melodie aus weniger eingeschränkten Inputs, einschließlich Liedtexten, generieren oder ableiten. Dieser Unterschied bestimmt, ob Sie eine bestimmte Note direkt reparieren oder eine andere Performance anfordern müssen.
Eine Performance-Beschreibung in Audio verwandeln
Das akustische Modell sagt eine Repräsentation wie ein Mel-Spektrogramm voraus, das beschreibt, wie Schallenergie über die Frequenz im Laufe der Zeit verteilt ist. Stellen Sie es sich als eine sich ändernde Karte des Stimmklangs vor, nicht als eine Audiodatei, die Sie bereits hören können.
Schlecht definierte Spektralmerkmale können zu dumpfen Vokalen, verschwommenen Konsonanten oder einer instabilen Stimmidentität führen. Aber Dumpfheit allein beweist nicht, dass das akustische Modell verantwortlich ist. Der finale Wellenformgenerator kann auch nützliche Details verdecken.
Der Vocoder wandelt die vorhergesagte Repräsentation in Klangproben um. Summen, Körnigkeit oder metallische Texturen können hier entstehen, insbesondere bei exponierten, gehaltenen Vokalen.
Identifizieren Sie vor der Bearbeitung, ob das Tool Noten akzeptiert und welche Steuerelemente die vermutete Phase beeinflussen. Versuchen Sie nicht, einen falsch platzierten Konsonanten mit Entzerrung zu korrigieren, oder eine raue Wellenform durch Umschreiben eines korrekt ausgesprochenen Liedtextes.
Warum Trainingsdaten entscheiden, wie gut eine Gesangsstimme klingt
Gesang aufzunehmen ist nur ein Teil des Aufbaus eines nützlichen Datensatzes. Entwickler benötigen auch zuverlässige Liedtexte, Notenausrichtung, Phonem-Timing und Anmerkungen, die beabsichtigte Ausdrucksweise von Fehlern unterscheiden. Ohne diesen Kontext könnte ein Modell ein akustisches Ereignis lernen, ohne zu lernen, wann es hingehört.
Der Korpusvergleich in der Singing-Datensatz-Übersicht veranschaulicht den begrenzten Umfang und die Sängerabdeckung mehrerer einflussreicher Ressourcen, die unten zusammengefasst sind.
Singing-Datensätze nach Größe und Abdeckung
| Korpus | Sänger | Stunden | Was es abdeckt |
|---|---|---|---|
| VocalSet | 20 | Etwa 10.1 | Gesangstechniken, Vokale und verschiedene Tonhöhen, keine vollständigen Lieder |
| NUS-48E | 12 | Etwa 2.8 | Kleiner Korpus mit begrenztem Sängerpool |
| MIR-1K | 19 | Etwa 2.2 | Kleiner Korpus mit begrenztem Sängerpool |
| CSD | 1 | Etwa 4.9 | 100 Lieder in zwei Sprachen von einem Sänger |
| SingNet | Nicht in der zitierten Zusammenfassung angegeben | Etwa 3,000 | In-the-wild-Gesang und Sample-Packs über Sprachen und Stile hinweg |
Das SingNet-Preprint berichtet über 2,629 Stunden In-the-wild-Gesang und 321 Stunden aus Sample-Packs, was insgesamt etwa 3,000 Stunden entspricht. Das stellt eine erhebliche Erweiterung des verfügbaren Materials dar, aber die Größe der Sammlung ist kein Garant für musikalische Abdeckung.
Abdeckung zählt genauso viel wie die Dauer
Der Fokus von VocalSet auf Techniken, Vokale und Tonhöhen macht es nützlich für die Untersuchung des Stimmverhaltens. Es macht es jedoch nicht austauschbar mit einem Korpus vollständiger, ausdrucksvoll formulierter Lieder. Ebenso kann eine Sammlung von einem einzelnen Sänger Konsistenz bieten, ohne zu zeigen, dass ein System über verschiedene Stimmidentitäten hinweg verallgemeinerbar ist.
Overfitting bedeutet, dass ein Modell zu stark von Mustern in seinem Trainingsmaterial abhängig wird. Beim praktischen Hören könnte das einen überzeugenden bekannten Vokal, aber eine unbeholfene unbekannte Aussprache bedeuten, oder ein starkes Ergebnis in einem repräsentierten Stil und ein nicht überzeugendes Ergebnis an anderer Stelle.
Für die Modellauswahl prüfen Sie:
- Sängerabdeckung: Suchen Sie nach dokumentierten Stimmumfängen und Identitäten, nicht nur nach einer gesamten Aufnahmedauer.
- Sprachabdeckung: Prüfen Sie, ob Ihre Liedtextsprache und Aussprachekonventionen repräsentiert sind.
- Musikalische Abdeckung: Unterscheiden Sie isolierte Übungen von vollständigen Phrasen, Übergängen und anhaltendem Ausdruck.
- Annotationsqualität: Suchen Sie nach einer Erklärung, wie Liedtexte und Noten mit den Aufnahmen abgeglichen wurden.
Die nützliche Frage ist nicht nur, wie viel Audio ein Entwickler gesammelt hat. Es ist, wie genau das dokumentierte Material der Leistung entspricht, die Sie benötigen. Fehlende Dokumentation schränkt ein, wie zuversichtlich Sie einen Qualitätsanspruch über eine ausgefeilte Demonstration hinaus anwenden können.
Akustische Modelle und Vocoder entscheiden, wo Qualität gewonnen wird
Der Wellenformgenerator kann die wahrgenommene Gesangsqualität wesentlich verändern, selbst wenn der vorgelagerte Prädiktor gleich bleibt. Das macht den Vocoder zu einer technischen Entscheidung, nicht nur zu einem Exportschritt.
In einer kontrollierten Studie zur neuronalen Gesangssynthese übertrafen CNN-basierte akustische Modelle entsprechende Feed-Forward-Netzwerke in Natürlichkeitstests, und der Ersatz des traditionellen MLSA-Vocoders durch WaveNet verbesserte beide Modellfamilien. Die Studie wurde mit 55 japanischen Kinderliedern und 55 J-Pop-Songs trainiert, fünf J-Pop-Songs wurden zurückgehalten, und es wurden fünfstufige mittlere Meinungsbewertungen von 15 Zuhörern verwendet, die zufällig ausgewählte Testphrasen bewerteten. Diese Ergebnisse unterstützen einen kontrollierten Vergleich, keine universelle Rangliste über Sänger, Sprachen oder Genres hinweg.
Vorhersagefehler von Rendering-Fehlern trennen
Ein akustisches Modell kann die falsche Vokalstruktur vorhersagen. Ein Vocoder kann eine vernünftige Vorhersage schlecht rendern. Beide Fehler können künstlich klingen, aber der Austausch derselben Komponente wird nicht beide beheben.
Für ein modulares System testen Sie den Vocoder mit akustischen Merkmalen, die aus einer sauberen Referenzaufnahme extrahiert wurden. Dies ist ein Resynthese-Test: Sie prüfen, wie gut die Wellenformstufe bereits vorhandene Informationen rekonstruiert, anstatt den akustischen Prädiktor zu bitten, sie zu erfinden.
Synthetisieren Sie dann aus der Partitur. Wenn die Referenz-Resynthese klar ist, aber die Partitur-gesteuerte Ausgabe undeutlich ist, untersuchen Sie die vorhergesagten Merkmale, die Ausrichtung und die Tonhöhenkonditionierung. Wenn die Referenzrekonstruktion bereits körnig klingt, kümmern Sie sich zuerst um den Vocoder oder die Feature-Kompatibilität.
Ersetzen Sie nicht das gesamte Modell, bevor Sie geprüft haben, ob der Defekt bereits vor der Wellenformgenerierung besteht.
Diese Unterscheidung ist auch wichtig bei der Bewertung angrenzender Sprachwerkzeuge. Eine Liste von Text-to-Speech-Modellen beschreibt eine andere Aufgabe; allein eine verständliche Sprachausgabe begründet weder die Qualität von gehaltenen Noten noch die Partiturkontrolle.
Wählen Sie Wiedergabetreue und Latenz für die tatsächliche Aufgabe
WaveNet-ähnliche autoregressive Vocoder generieren Audio sequenziell, was die Latenz erhöhen kann. Schnellere Alternativen, einschließlich LPCNet, können geeigneter sein, wenn eine reaktionsschnelle Wiedergabe wichtig ist.
Für das Offline-Rendering können Sie eine längere Wartezeit in Kauf nehmen, um vokale Details zu erhalten. Für die interaktive Komposition bevorzugen Sie möglicherweise eine schnelle Vorschau und reservieren ein Rendering höherer Qualität für die Überprüfung.
Messen Sie sowohl die Generierungszeit als auch die hörbaren Artefakte in Ihrem beabsichtigten Workflow. Ein schönes isoliertes Rendering ist weniger nützlich, wenn es jede kleine Melodiebearbeitung unterbricht, während eine reaktionsschnelle Vorschau nicht mit der besten endgültigen Ausgabe verwechselt werden sollte, die das System produzieren kann.
Wie man ein System zur Gesangssynthese beurteilt
Eine Stimme kann natürlich klingen, während sie vom Ton abweicht, oder die Noten genau treffen, während sie dünn klingt. Keine einzelne Qualitätsbewertung beschreibt die gesamte Leistung. Sie benötigen Urteile von Zuhörern zusammen mit Messungen des generierten Signals.
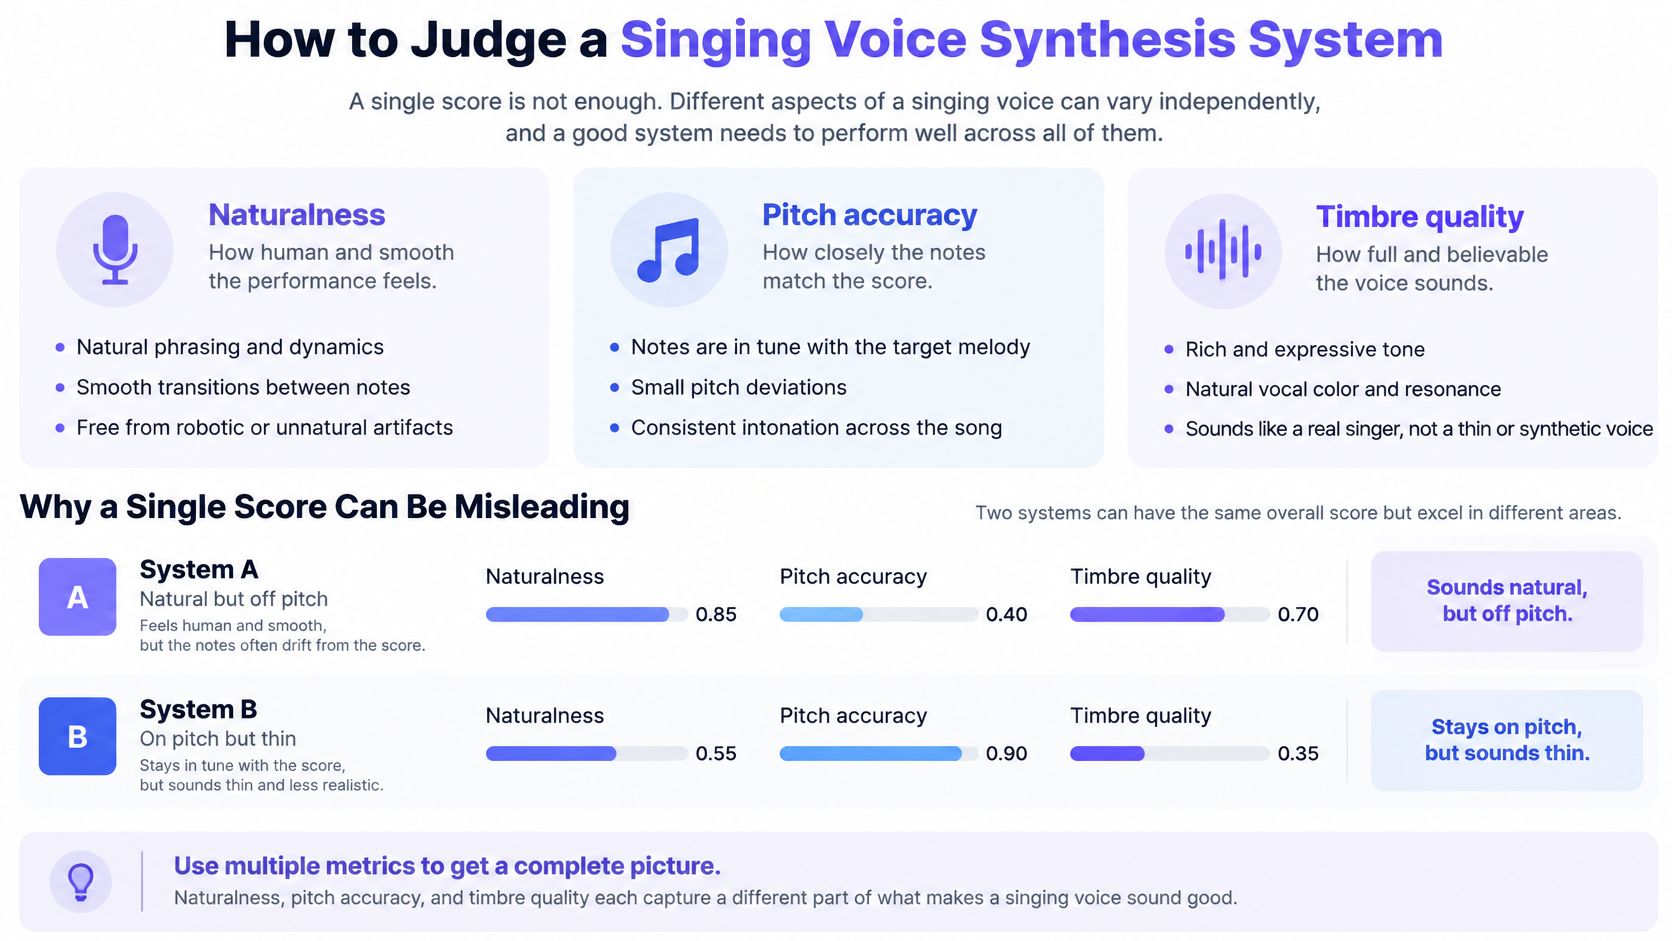
Das WeSinger 2 paper verwendet MOS, F0 root-mean-square error und Mel-Spektrogramm-Verzerrung, um komplementäre Aspekte der Gesangsqualität zu untersuchen. Sein mehrsängerisches bedingtes adversarielles Training verbessert den MOS gegenüber dem früheren WeSinger-System auf Opencpop und Data-L, aber die vergleichenden Gewinne unterscheiden sich über die Datensätze hinweg, was die Bedeutung von Sänger- und Korpusbedingungen unterstreicht.
Metriken zur Beurteilung der Qualität von Gesangssynthese
| Metrik | Was sie erfasst | Was sie nicht erfasst |
|---|---|---|
| MOS | Gesamte wahrgenommene Qualität von Zuhörern | Kann Tonhöhenabweichungen und sängerspezifische Details verdecken |
| F0 RMSE | Pitch, Intonation und Stimmfehler | Behauchtheit, Aussprache und Klangfarbe |
| MSD | Spektrale Diskrepanz, verbunden mit Klangfarbe und Artikulation | Ob eine Phrase ausdrucksstark oder stilgerecht wirkt |
Messungen gemeinsam betrachten
MOS, oder Mean Opinion Score, fasst die Bewertungen von Zuhörern zusammen. Er ist nützlich, um zu fragen, ob Menschen das Gesamtergebnis bevorzugen, aber die Interpretation hängt davon ab, was sie gehört haben und was sie beurteilen sollten.
F0 RMSE misst Fehler in der Grundfrequenz, der akustischen Größe, die mit der wahrgenommenen Tonhöhe verbunden ist. Es hilft, Stimmprobleme aufzudecken, aber es beweist nicht, dass die Wörter verständlich oder der Gesangston glaubwürdig ist.
MSD vergleicht spektrale Darstellungen. Es kann Unterschiede im Zusammenhang mit Artikulation und Klangfarbe aufzeigen, aber das Anpassen an ein Referenzspektrogramm ist nicht dasselbe wie eine überzeugende künstlerische Wahl zu treffen.
Hörprobe: Hören Sie sich den Gesang allein an, bevor Sie ihn in einem dichten Mix beurteilen. Begleitung kann schwache Konsonanten und instabile Notenenden schwerer erkennbar machen.
Erstellen Sie einen Evaluierungssatz, der unbekannte Lieder und, falls das System dies unterstützt, zurückgehaltene Sänger enthält. Fügen Sie gehaltene Vokale, konsonantenreiche Texte, Registerwechsel und Phrasen hinzu, die ein bewusst ausdrucksvolles Timing erfordern.
Berichten Sie die Metriken gemeinsam, und achten Sie dann speziell auf Behauchtheit, Aussprache und Gesangsidentität. Wenn ein Anbieter nur einen Schlagzeilen-Natürlichkeitswert anbietet, behandeln Sie dies als Beweis für diesen Hörtest, nicht als Beweis dafür, dass Ihr Text, Sänger und Arrangement gleichermaßen gut funktionieren werden.
Praktische Einsatzmöglichkeiten, Grenzen und kulturelle Lücken
Ein Songwriter kann synthetischen Gesang nutzen, um zu prüfen, ob ein Refrain singbar ist, bevor er eine Session arrangiert. Ein Produzent kann eine Harmonie ausprobieren, während ein Spielteam testen kann, wie das Lied eines Charakters zu einer Szene passt. Dies sind praktische Anwendungen, da die generierte Performance Menschen hilft, eine konkrete Produktionsentscheidung zu treffen.
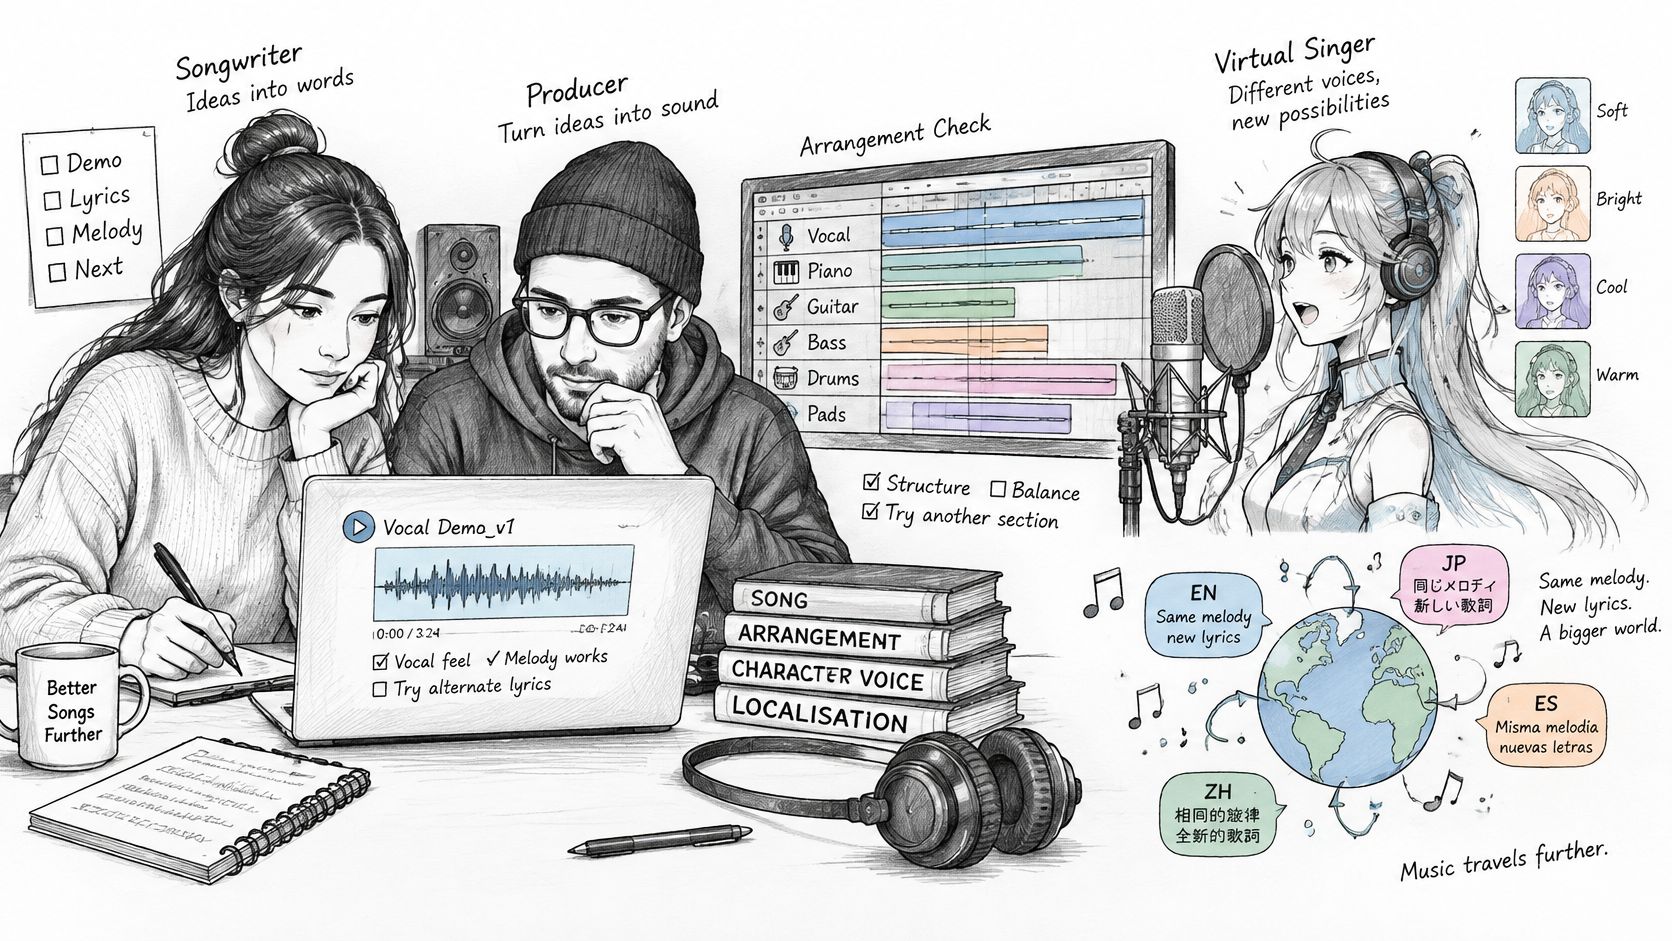
Charakterzentrierte Veröffentlichungen und Animationsprototypen können ebenfalls eine bewusst synthetische Gesangsästhetik nutzen. Für audiovisuelles Prototyping kann ein Leitfaden zur Erstellung eines KI-Musikvideos helfen, den Audio-Workflow mit der visuellen Produktion zu verbinden, aber der Gesang benötigt immer noch eine eigene musikalische Überprüfung.
Ausdruck testen, nicht nur korrekte Noten
Lokalisierung ist ein nützliches Beispiel dafür, wie eine scheinbar einfache Aufgabe anspruchsvoll wird. Die Beibehaltung der Melodie bei Sprachwechseln bedeutet, neue Silben, Betonungsmuster und Konsonanten in eine bestehende Phrase einzufügen. Eine wörtliche Übersetzung kann als gesungener Text ungeeignet sein.
Kulturspezifischer Ausdruck fügt eine weitere Ebene hinzu. Das Kapitel über indischen klassischen Gesang beschreibt Verzierungen in Bezug auf die jeweilige Note, den Raga, den Sänger und den musikalischen Kontext – Details, die herkömmliche Tonhöhen- und Verständlichkeitsmessungen möglicherweise übersehen.
Nutzen Sie gezielte Tests, anstatt nur zu fragen, ob das Ergebnis menschlich klingt:
- Verzierung: Lassen Sie einen mit der Tradition vertrauten Musiker die Bewegung zwischen und um die Noten beurteilen.
- Code-Switching: Platzieren Sie einen Sprachwechsel innerhalb einer Phrase und überprüfen Sie Akzent, Betonung und Kontinuität der Gesangsidentität.
- Seltene Wörter: Testen Sie Namen und unbekanntes Liedvokabular und lassen Sie dann einen fließend sprechenden Muttersprachler die Aussprache beurteilen.
- Phrasierung: Vergleichen Sie, wo der generierte Sänger atmet, ein Wort betont oder ein gehaltenes Ende loslässt.
Herkunft getrennt von Qualität überprüfen
Ein überzeugender Gesang belegt nicht, wer ihn dargeboten hat. Der Bericht des National Institute of Justice über die erste Singing Voice Deepfake Detection Challenge meldet 47 teilnehmende Teams und eine Equal-Error-Rate von 1.65% des Spitzenteams im Rahmen der Challenge.
Dieses Ergebnis zeigt die gemessene Detektorleistung unter bestimmten Bedingungen, nicht die garantierte Authentifizierung einer beliebigen Veröffentlichung. Behandeln Sie die Erkennung als eine Überprüfung neben Herkunftsnachweisen, Quelldateien und dokumentierter Autorisierung.
Synthetischer Gesang ist besonders nützlich für Entwürfe, Prototypen und absichtliche Charakterstimmen. Ein endgültiger kommerzieller Gesang, insbesondere bei einer großen Veröffentlichung, erfordert eine menschliche Überprüfung hinsichtlich musikalischen Ausdrucks, sprachlicher Genauigkeit, Identität und Herkunft, anstatt einer Genehmigung, die allein auf einer sauber klingenden Demo basiert.
Rechte bestätigen, bevor Sie ein Gesangsmodell erstellen oder kaufen
Wer hat die Stimme autorisiert, bevor sie trainiert, geklont oder veröffentlicht wird? Eine Gesangsaufnahme kann einen Interpreten, einen Eigentümer der Aufnahme, einen Texter und einen Komponisten umfassen. Eine Genehmigung bezüglich eines Beitrags regelt nicht automatisch die anderen.
Der AI & Society Artikel zur Governance von Gesangsdaten warnt davor, dass eine Standard-Creative-Commons-Lizenz die Beitragenden von Gesangsdaten möglicherweise nicht ausreichend schützt, da Aufnahmen sowohl die Stimme eines Interpreten als auch ein urheberrechtlich geschütztes Lied enthalten können. Er unterscheidet auch die US-amerikanischen Fair-Use-Regeln von der EU-Ausnahme für Text- und Data-Mining, anstatt sie als austauschbare Genehmigungen zu behandeln.
Die erlaubten Nutzungen schriftlich festhalten
Verwenden Sie eine Rechte-Checkliste, bevor Sie Aufnahmen übertragen oder ein Modell integrieren:
- Die relevanten Rechte identifizieren. Dokumentieren Sie Genehmigungen bezüglich der Aufnahmen des Sängers, der Texte, der Komposition, des Abbilds und der beabsichtigten kommerziellen Veröffentlichung. Halten Sie fest, wer jede Nutzung autorisieren kann, anstatt anzunehmen, dass die Person, die die Datei liefert, alles kontrolliert.
- Die Modellaktivitäten spezifizieren. Geben Sie an, ob die Vereinbarung Training, Fine-Tuning, Stimmklonung, Weiterverbreitung und nachgelagerte kommerzielle Nutzung erlaubt. Eine Lizenz zur Veröffentlichung eines Audiotracks sollte nicht zur Erlaubnis werden, ein wiederverwendbares Stimmmodell zu erstellen.
- Die Lizenzbedingungen lesen. Verlassen Sie sich nicht allein auf ein Creative-Commons-Label. Prüfen Sie, ob die Bedingungen den Beitrag des Interpreten und das zugrunde liegende Lied berücksichtigen.
- Die anwendbare Gerichtsbarkeit prüfen. Lassen Sie qualifizierte Rechtsberater die Regeln bewerten, die für die Aufnahmen, Beitragenden und die Bereitstellung relevant sind. Übertragen Sie keine Ausnahme aus einem anderen Rechtssystem in Ihre Vereinbarung.
- Planen, was nach dem Training geschieht. Definieren Sie Widerrufsverfahren, Modellentfernung, Namensnennung und Umsatzbeteiligung. Legen Sie fest, wer Anfragen bearbeitet und welche Abhilfemaßnahmen technisch und vertraglich verfügbar sind.
Beweismittel bei den Produktions-Assets aufbewahren
Führen Sie eine Genehmigungsdokumentation neben dem Datensatz oder Projekt. Fügen Sie die Vereinbarungsversion, die erlaubten Nutzungen, die Kennungen der Quellaufnahmen und alle Vertriebsbeschränkungen hinzu. Das erleichtert es, eine autorisierte Eingabe von einer Datei zu unterscheiden, die lediglich in einem freigegebenen Ordner angekommen ist.
Öffentliche Verfügbarkeit ist kein Nachweis für Zustimmung oder Eigentum. Auch sollte ein Versprechen, eine Aufnahme zu entfernen, nicht mit einer nachgewiesenen Fähigkeit verwechselt werden, ihren Einfluss aus einem bereits trainierten Modell zu entfernen.
Bevor Sie ein Gesangsmodell erstellen oder kaufen, holen Sie schriftliche Bedingungen ein, die jedes relevante Recht, jede erlaubte Aktivität und jede Verpflichtung nach dem Training abdecken.
MartLLM ist eine API für Text-, Bild-, Video-, Musik- und Sprachmodelle. Wenn Sie einen produktionsbezogenen Workflow für Gesang erstellen, besuchen Sie MartLLM, um Modellangebote zu erkunden und deren dokumentierte Eingaben mit Ihren Anforderungen an Partiturkontrolle, Audioausgabe und umgebende Medienaufgaben zu vergleichen.