歌声合成:仕組みと限界
歌声合成が歌詞と音符を歌声に変換する仕組み、学習データとボコーダーが何を制御しているのか、そしてまだ不十分な点はどこにあるのかについて学びましょう。
メロディーを作り、歌詞を合わせ、合成シンガーを読み込んだとします。最初の再生は期待が持てるものでしたが、ある単語が早口で通り過ぎ、伸ばした音が金属的になり、コーラスが奇妙に無表情に聞こえるようになると、その印象は変わってしまいます。これらの問題は必ずしも同じ原因ではありません。それぞれがシグナルチェーンのどこで発生するかを理解することで、ボーカルの修正は当てずっぽうではなく、はるかに確実なものになります。
目次
- 歌声合成とは何か、その成り立ち
- 歌声合成システムが楽譜を音に変える仕組み
- 訓練データが歌声の品質を左右する理由
- 音響モデルとボコーダーが品質を決定する場所
- 歌声合成システムを評価する方法
- 実用的な用途、限界、文化的なギャップ
- 歌声モデルを構築または購入する前に権利を確認する
歌声合成(SVS)とは何か、その歴史
**歌声合成(SVS)**は、歌詞、音高と音の長さを持つ音符のシーケンス、そして多くのシステムでは選択された歌手のアイデンティティから、歌唱オーディオを生成します。例えば、メロディは完成しているけれど歌い手がいない作曲家だとします。音符と歌詞を入力することで、ボーカルラインがアレンジにどのようにフィットするかを聴くことができます。
これは単に音楽の伴奏付き音声合成ではありません。話された文には説得力のあるフレーズが必要ですが、歌われた文は音楽の音高に従い、母音を持続させ、子音を拍の周りに配置する必要があります。会話では許容される音節でも、長い音符に引き伸ばされると不自然に聞こえることがあります。
録音された断片から学習された声へ
初期のアプローチでは、ルールと信号処理が用いられ、その後、録音されたボーカルユニットを組み立てるシステムが登場しました。統計的およびニューラルなアプローチは、断片をつなぎ合わせるだけに頼るのではなく、歌詞、音楽的指示、音響出力間の関係を学習するようになりました。
ヤマハによるVOCALOID開発の経緯]によると、このプロジェクトはバルセロナのUniversitat Pompeu FabraとのDAISYコラボレーションを通じて2000年2月に始まり、最初の商用製品は2004年に登場しました。開発者たちは、通常のコンピューター入力や従来の音声技術では歌唱を適切に再現できなかったため、専用の歌唱データベースを必要としました。
初音ミクのようなバーチャルシンガーも、合成歌唱をキャラクター中心のクリエイティブなメディアに変えるのに貢献しました。その声は、レコーディングセッションにおける単なる代替トラックではなく、芸術的アイデンティティの一部となり得ました。
役立つ区別: 音楽演奏を生成することと、歌唱メロディを音符ごとに制御することは、同じ要件ではありません。
音楽生成モデルのリスト]を閲覧する際は、すべての音楽ツールがボーカルスコアを受け入れると仮定するのではなく、入力コントロールを確認してください。実用的な歌唱システムのためには、その信号チェーンを理解し、品質の限界を認識し、その声がどのように評価され、ライセンスされるかを確立する必要があります。
歌声合成システムが楽譜を音に変える仕組み
何が入力され、何が出力されるのでしょうか?楽譜制御のワークフローでは、入力は音楽的な指示のセットです。出力は、再生、編集、ミックスが可能な波形です。
歌声合成システムのパイプライン段階
| 段階 | 入力 | 出力 | 制御内容 |
|---|---|---|---|
| 歌詞・楽譜フロントエンド | 歌詞、音のピッチ、音の長さ | タイミング付きフォニームシーケンス | どの音をどの拍で歌うか |
| 音長・ピッチモデル | フォニーム、楽譜 | フレームレベルのタイミングとピッチカーブ | ビブラート、音の立ち上がり、ピッチの正確さ |
| 音響モデル | フォニーム、タイミング、ピッチ、歌い手の個性 | メルスペクトログラム | 音色、母音の形状、発音 |
| ボコーダー | メルスペクトログラム | 音声波形 | 明瞭さ、息遣い、可聴ノイズ |
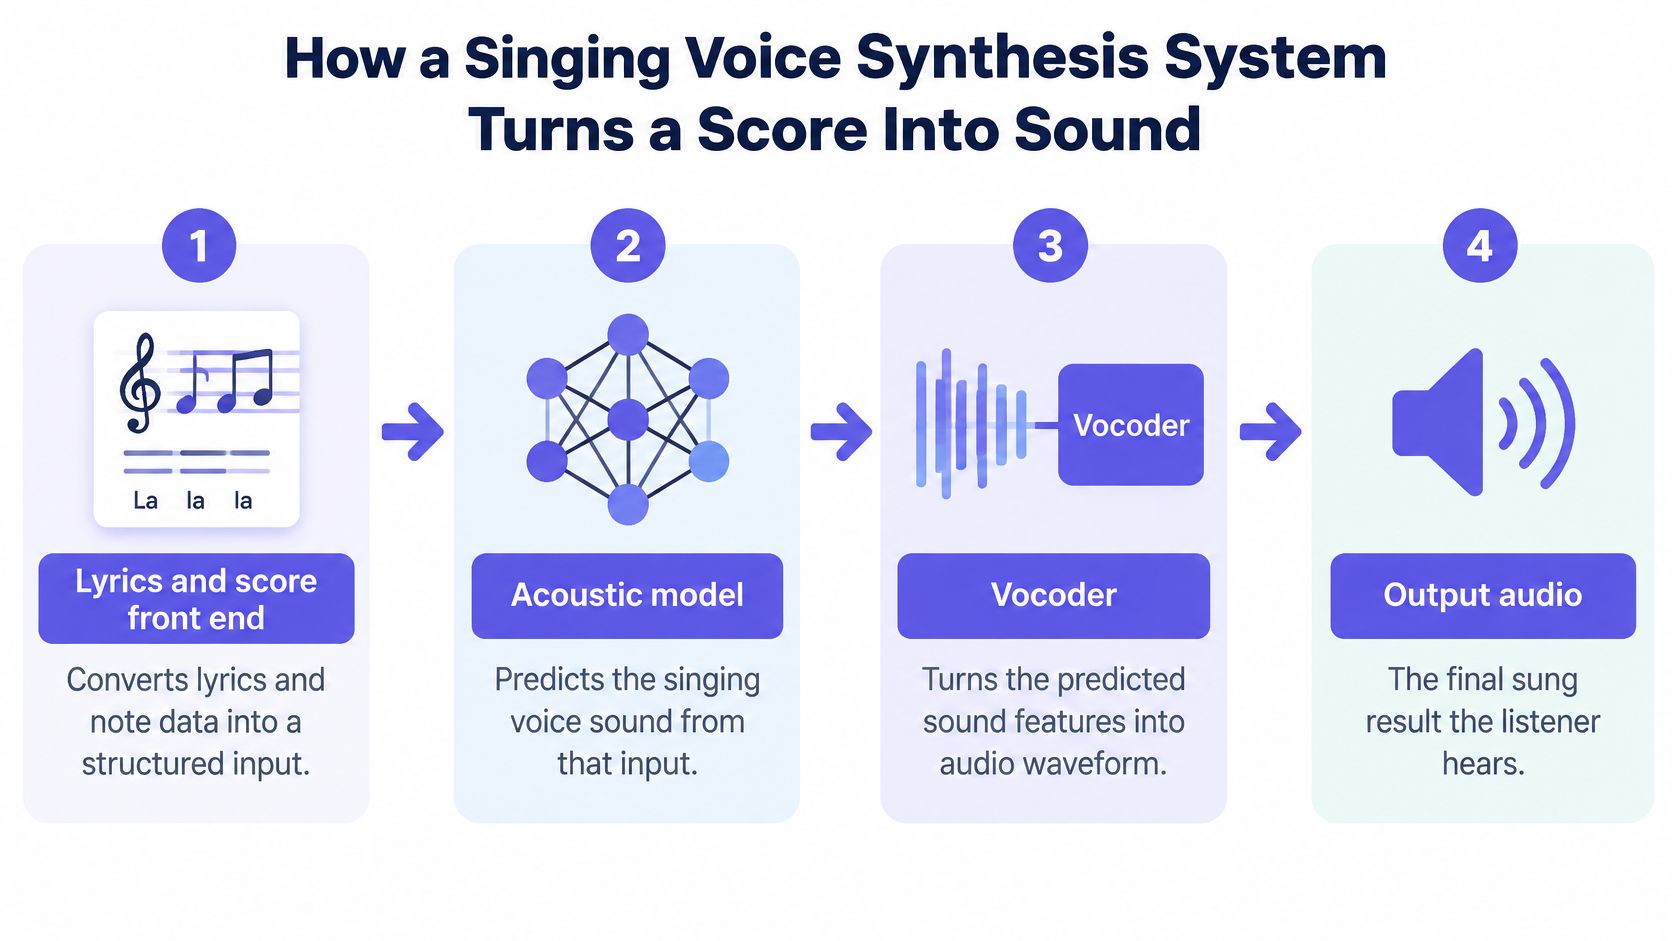
この図は、音長とピッチの決定が予測プロセスに組み込まれた、より広範な流れを示しています。
言葉と音符をパフォーマンスに変える
フロントエンドは、歌詞を単語内の個々の音声であるフォニームに分解し、それらを音符と関連付けます。書かれた音節は、単一の途切れない音ではありません。stay の場合、冒頭の子音は、持続するピッチを担う母音とは異なる処理が必要です。
システムが子音に時間をかけすぎると、母音が遅れてしまうことがあります。それを補うために母音を短くすると、音符が時間通りに終わっても、単語が急いでいるように聞こえます。歌詞がリズム的に間違っていると感じたら、発音とフォニームの配置から始めましょう。
音長・ピッチモデルは、それらの音が時間とともにどのように展開するかを決定します。音符は目標ピッチを指定しますが、実際に演奏されるピッチカーブには、穏やかなアプローチ、安定した中心、そして終わりに向かってのビブラートが含まれる場合があります。完全に平坦なカーブは硬く聞こえることがあり、誇張された移行は意図しないスクープのように聞こえることがあります。
一部のツールは明示的な音符データを受け入れますが、歌詞を含む制約の少ない入力からメロディを生成または推測するものもあります。この違いによって、特定の音符を直接修正できるか、別のパフォーマンスを要求する必要があるかが決まります。
パフォーマンス記述を音声に変える
音響モデルは、時間とともに音響エネルギーが周波数全体にどのように分布するかを記述する、メルスペクトログラムのような表現を予測します。これは、すでに聞くことができるオーディオファイルではなく、声の音色の変化する地図だと考えてください。
不十分に定義されたスペクトル特徴は、くぐもった母音、不明瞭な子音、または不安定な声の個性を生み出す可能性があります。しかし、くぐもりだけでは音響モデルが原因であるとは限りません。最終的な波形生成器も、有用な詳細を不明瞭にすることがあります。
ボコーダーは、予測された表現を音声サンプルに変換します。特に露出した持続母音では、ブーンという音、ざらつき、または金属的な質感がここで発生する可能性があります。
編集する前に、ツールが音符を受け入れるかどうか、そしてどのコントロールが疑わしい段階に影響するかを特定してください。誤った位置の子音をイコライゼーションで修正しようとしたり、正しく発音された歌詞を書き直すことで粗い波形を修正しようとしたりしないでください。
なぜトレーニングデータが歌声の質を左右するのか
歌声を録音することは、有用なデータセットを構築する上での一部に過ぎません。開発者は、信頼できる歌詞、音符のアライメント、音素のタイミング、そして意図された表現と間違いを区別するアノテーションも必要とします。そのようなコンテキストがなければ、モデルはそれがいつ属するべきかを学習することなく、音響イベントを学習してしまう可能性があります。
歌唱データセット調査]におけるコーパス比較は、いくつかの影響力のあるリソースの限られた規模と歌手の網羅性を示しており、以下にまとめられています。
規模と網羅性で見る歌唱データセット
| コーパス | 歌手数 | 時間 | 内容 |
|---|---|---|---|
| VocalSet | 20 | 約10.1 | 歌唱テクニック、母音、多様なピッチ。完全な楽曲ではない |
| NUS-48E | 12 | 約2.8 | 歌手のプールが限られた小規模コーパス |
| MIR-1K | 19 | 約2.2 | 歌手のプールが限られた小規模コーパス |
| CSD | 1 | 約4.9 | 一人の歌手による2言語の100曲 |
| SingNet | 引用された要約には記載なし | 約3,000 | 言語やスタイルを横断するインザワイルド歌唱とサンプルパック |
SingNetプレプリント]は、インザワイルド歌唱2,629時間、サンプルパックからの歌唱321時間、合計約3,000時間を報告しています。これは利用可能な素材の大幅な拡大を意味しますが、収集規模は音楽的網羅性の証明ではありません。
期間と同じくらい網羅性が重要
VocalSetがテクニック、母音、ピッチに焦点を当てていることは、発声行動の研究に役立ちます。それは、完全で表現豊かなフレーズの楽曲コーパスと互換性があるわけではありません。同様に、単一歌手のコレクションは一貫性を提供できますが、システムが複数の歌声のアイデンティティにわたって一般化できることを示すものではありません。
過学習とは、モデルがトレーニング素材のパターンに過度に依存してしまうことを意味します。実際のリスニングでは、それは説得力のある聞き慣れた母音とぎこちない聞き慣れない発音、あるいは表現されたスタイルでは強力な結果だが、それ以外の場所では説得力のない結果を意味するかもしれません。
モデル選択のために、以下を検討してください。
- 歌手の網羅性: 総録音時間だけでなく、文書化された声域とアイデンティティを探してください。
- 言語の網羅性: あなたの歌詞の言語と発音の慣習が表現されているか確認してください。
- 音楽的網羅性: 孤立した練習と、完全なフレーズ、移行、持続的な表現を区別してください。
- アノテーションの品質: 歌詞と音符が録音とどのようにアライメントされたかの説明を探してください。
有用な問いは、開発者がどれだけのオーディオを収集したかだけではありません。それは、文書化された素材があなたが必要とするパフォーマンスとどれだけ密接に一致しているかです。ドキュメントが不足していると、洗練されたデモンストレーションを超えて品質の主張をどれだけ自信を持って適用できるかが制限されます。
音響モデルとボコーダーが品質を左右する
波形生成器は、上流の予測器が同じままであっても、知覚される歌唱品質を大きく変える可能性があります。そのため、ボコーダーは単なるエクスポート手順ではなく、エンジニアリング上の選択となります。
制御されたニューラル歌唱合成の研究では、CNNベースの音響モデルが自然さのテストで対応するフィードフォワードネットワークを上回り、従来のMLSAボコーダーをWaveNetに置き換えることで両方のモデルファミリーが改善されました。この研究では、55曲の日本の童謡と55曲のJ-POPで学習し、5曲のJ-POPをホールドアウトし、ランダムに選択されたテストフレーズを評価する15人のリスナーからの5段階の平均意見スコアを使用しました。これらの結果は、制御された比較を支持するものであり、歌手、言語、またはジャンルを超えた普遍的なランキングではありません。
予測エラーとレンダリングエラーを区別する
音響モデルは誤った声の構造を予測する可能性があります。ボコーダーは合理的な予測を不十分にレンダリングする可能性があります。どちらの失敗も不自然に聞こえるかもしれませんが、同じコンポーネントを置き換えても両方が修正されるわけではありません。
モジュール式のシステムの場合、クリーンな参照録音から抽出された音響特徴を使用してボコーダーをテストします。これは再合成テストです。音響予測器に情報を発明させるのではなく、波形ステージが既に存在する情報をどれだけうまく再構築するかを確認するものです。
次に、楽譜から合成します。参照再合成がクリアなのに楽譜駆動の出力が不明瞭な場合は、予測された特徴、アライメント、ピッチコンディショニングを調査してください。参照再構築が既にざらざらした音に聞こえる場合は、まずボコーダーまたは特徴の互換性に対処してください。
波形生成前に欠陥が存在するかどうかを確認するまで、モデル全体を置き換えないでください。
この区別は、隣接する音声ツールを評価する際にも重要です。テキスト読み上げモデルのリストは異なるタスクを記述しており、理解可能な音声出力だけでは、持続音の品質や楽譜制御を確立するものではありません。
実際の作業に合わせて忠実度とレイテンシーを選択する
WaveNetのような自己回帰型ボコーダーは音声を順次生成するため、レイテンシーが増加する可能性があります。応答性の高い再生が重要な場合は、LPCNetを含むより高速な代替手段がより適切かもしれません。
オフラインレンダリングの場合、歌唱のディテールを保持するために、より長い待ち時間を受け入れるかもしれません。インタラクティブな作曲の場合、迅速なプレビューを好み、レビュー用に高品質なレンダリングを予約するかもしれません。
意図するワークフローの下で、生成時間と聞こえるアーティファクトの両方を測定してください。美しい単独のレンダリングも、小さなメロディの編集ごとに中断されるようではあまり役に立ちません。一方、応答性の高いプレビューは、システムが生成できる最高の最終出力と混同すべきではありません。
歌声合成システムの評価方法
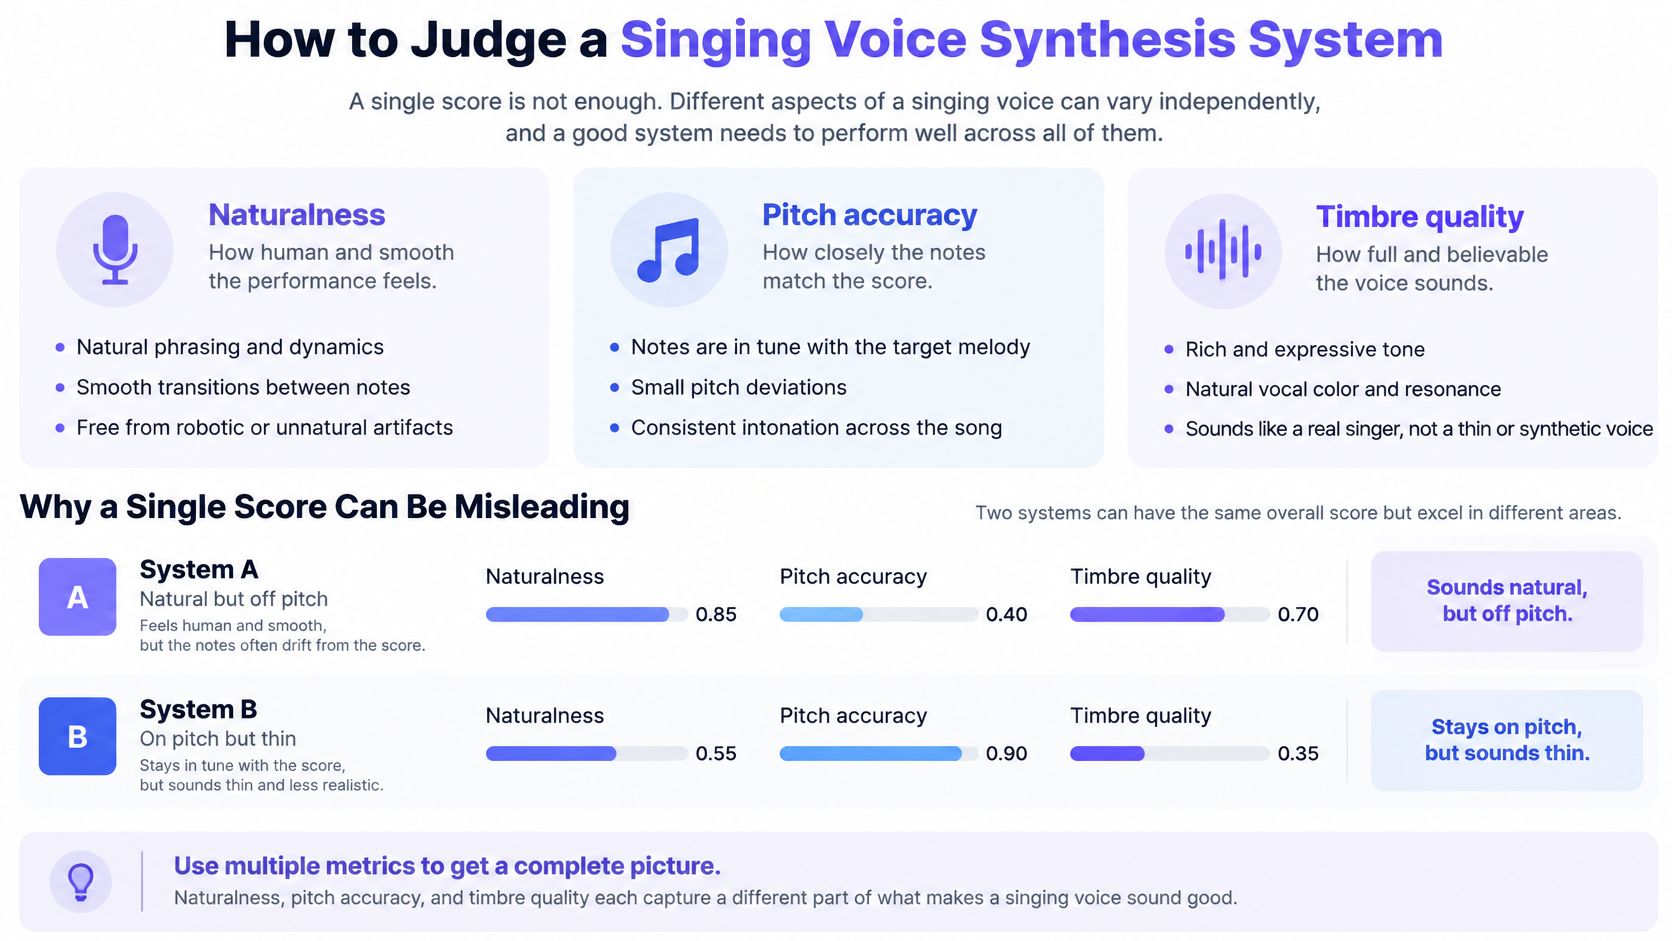
声は、音程がずれていても自然に聞こえることもあれば、正確に音符を追っていても薄っぺらく聞こえることもあります。単一の品質スコアだけでは、パフォーマンス全体を説明できません。 生成された信号の測定値と合わせて、リスナーの判断が必要です。
 ](image.png)
WeSinger 2 の論文では、歌声の品質の補完的な側面を調べるために、MOS、F0 二乗平均平方根誤差、およびメルスペクトログラム歪みが使用されています。そのマルチシンガー条件付き敵対的学習は、OpencpopとData-Lにおいて、以前のWeSingerシステムよりもMOSを向上させますが、データセット間で比較上の利得が異なるため、歌手とコーパスの条件の重要性が強調されます。
歌声合成の品質を評価するための指標
| 指標 | 捉えられるもの | 見落とすもの |
|---|---|---|
| MOS | リスナーからの全体的な知覚品質 | 音程のずれや歌手固有の詳細を隠蔽する可能性がある |
| F0 RMSE | 音程、イントネーション、チューニングの誤差 | 息遣い、発音、音色 |
| MSD | 音色と発音に関連するスペクトル不一致 | フレーズが表現豊かであるか、スタイルに合っているか |
測定値を総合的に見る
MOS、または平均意見スコアは、リスナーの評価を要約したものです。人々が全体的な結果を好むかどうかを問うのに役立ちますが、その解釈は、彼らが何を聞き、何を判断するよう求められたかによって異なります。
F0 RMSEは、知覚される音程に関連する音響量である基本周波数の誤差を測定します。チューニングの問題を明らかにするのに役立ちますが、言葉が聞き取りやすいか、ボーカルのトーンが信じられるものであるかを確立するものではありません。
MSDはスペクトル表現を比較します。発音と音色に関連する違いを明らかにできますが、参照スペクトログラムに合わせることが、説得力のある芸術的選択をすることと同じではありません。
リスニングチェック: 密なミックスの中で判断する前に、ボーカル単独で試聴してください。伴奏があると、弱い子音や不安定な音の終わりが気づきにくくなることがあります。
なじみのない曲や、システムがサポートする場合は、評価セットに未公開の歌手を含めてください。持続する母音、子音の多い歌詞、レジスターの変化、意図的な表現のタイミングを必要とするフレーズを含めてください。
指標をまとめて報告し、その上で息遣い、発音、ボーカルの個性について具体的に聴き取ってください。もしベンダーが主要な自然さスコアのみを提供する場合、それはそのリスニングテストに関する証拠として扱い、あなたの歌詞、歌手、アレンジが同様にうまく機能するという証明ではないと見なします。
実用的な用途、限界、文化的な隔たり
ソングライターは、セッションを手配する前に、合成歌唱を使ってコーラスが歌いやすいかを確認できます。プロデューサーはハーモニーを試聴でき、ゲームチームはキャラクターの歌がシーンに合うかテストできます。これらは、生成されたパフォーマンスが具体的な制作決定を下すのに役立つため、実用的な用途です。
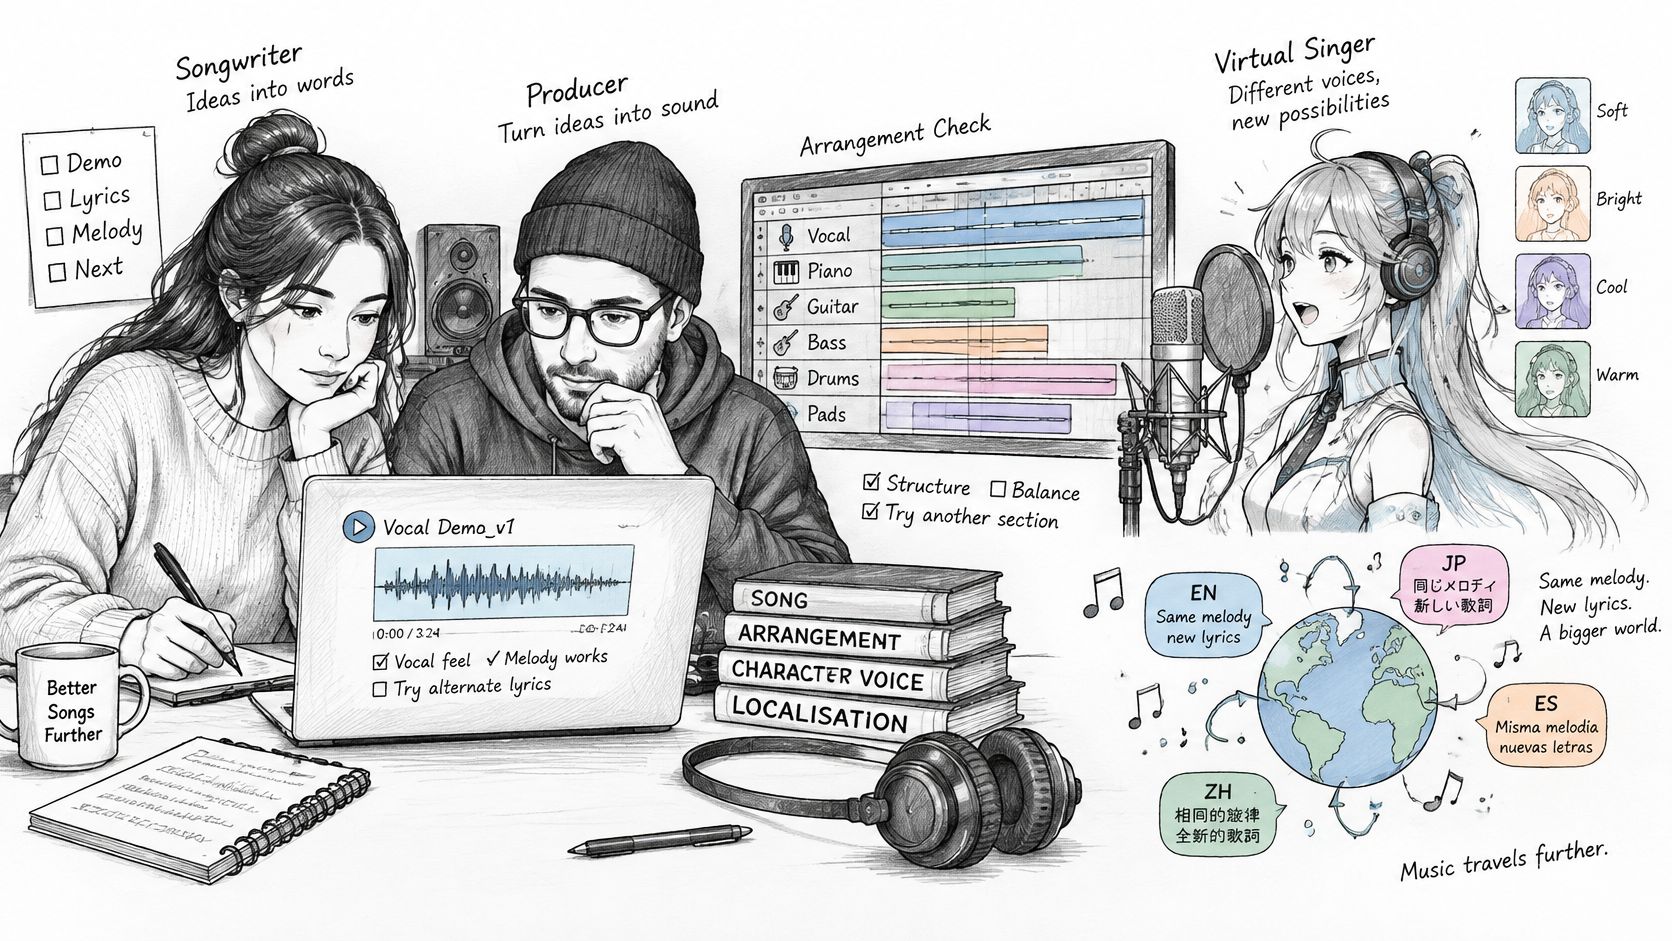
キャラクター中心のリリースやアニメーションのプロトタイプは、意図的に合成されたボーカルの美学を用いることもできます。オーディオビジュアルのプロトタイピングには、AIミュージックビデオの作り方ガイドがオーディオワークフローをビジュアル制作に接続するのに役立ちますが、ボーカルは依然として独自の音楽的レビューが必要です。
正しい音符だけでなく表現をテストする
ローカライズは、一見シンプルなタスクが困難になる場所の有用な例です。言語を変更しながらメロディを維持することは、新しい音節、アクセントパターン、子音を既存のフレーズに合わせることを意味します。直訳は歌唱歌詞として不適切である可能性があります。
文化的に固有の表現はもう一つの層を追加します。インド古典歌唱に関する章は、特定の音符、ラーガ、歌手、音楽的文脈との関連で装飾を記述しており、従来のピッチと明瞭度の測定では見落とされがちな詳細です。
結果が人間らしく聞こえるかどうかだけを問うのではなく、ターゲットを絞ったテストを使用してください。
- 装飾: その伝統に精通したミュージシャンに、音符間および音符周辺の動きを判断してもらいます。
- コードスイッチング: フレーズ内に言語の変更を配置し、アクセント、ストレス、ボーカルのアイデンティティの連続性を確認します。
- 珍しい単語: 名前やなじみのない歌詞の語彙をテストし、流暢な話者に発音を評価してもらいます。
- フレーズ: 生成された歌手がどこで息継ぎをするか、単語を強調するか、または持続する終わりを解放するかを比較します。
品質とは別に出所を確認する
説得力のあるボーカルは、誰がそれを歌ったかを確立しません。国立司法研究所による第1回歌声ディープフェイク検出チャレンジの報告は、チャレンジ設定において47の参加チームとトップチームの**等エラー率1.65%**を報告しています。
その結果は、特定の条件下での測定された検出器の性能を示しており、任意のリリースに対する認証を保証するものではありません。検出は、出所記録、ソースファイル、文書化された承認と並行して、一つのチェックとして扱ってください。
合成歌唱は、下書き、プロトタイプ、意図的なキャラクターボイスに特に有用です。最終的な商業ボーカルは、特に主要なリリースにおいては、クリーンなサウンドのデモのみに基づく承認ではなく、音楽的表現、言語の正確さ、アイデンティティ、出所について人間によるレビューが必要です。
歌唱モデルを構築または購入する前に権利を確認する
訓練、クローン作成、またはリリースする前に、その声の許可を誰から得ていますか?歌唱録音には、パフォーマー、録音所有者、作詞家、作曲家が関与する可能性があります。ある貢献に関する許可が、他の貢献を自動的に解決するわけではありません。
歌唱データガバナンスに関するAI & Societyの記事は、録音にはパフォーマーの声と著作権で保護された楽曲の両方が含まれる可能性があるため、標準的なCreative Commonsライセンスでは歌唱データの貢献者を適切に保護できない可能性があると警告しています。また、米国のフェアユース規則とEUのテキスト・データマイニング例外を、互換性のある許可として扱うのではなく、区別しています。
許可された使用を書面にする
録音を転送したり、モデルを統合したりする前に、権利チェックリストを使用してください。
- 関連する権利を特定する。 歌手の録音、歌詞、作曲、肖像、および意図された商業リリースに関する許可を文書化します。ファイルを提供する人物がすべてを管理していると仮定するのではなく、各使用を誰が許可できるかを記録します。
- モデルの活動を明記する。 契約がtraining、fine-tuning、voice cloning、redistribution、およびdownstream commercial useを許可しているかどうかを明記します。オーディオトラックを公開するライセンスが、再利用可能な音声モデルを構築する許可になってはなりません。
- ライセンス条項を読む。 Creative Commonsのラベルだけに頼らないでください。条項がパフォーマーの貢献と原曲に対応しているか確認してください。
- 適用される管轄区域を確認する。 録音、貢献者、およびdeploymentに関連する規則を、資格のある弁護士に評価してもらいます。他の法制度からの例外をあなたの契約に移植しないでください。
- 訓練後に何が起こるかを計画する。 取り消し手順、モデルの削除、attribution、およびrevenue sharingを定義します。誰が要求を処理し、技術的および契約的にどのような救済策が利用可能かを明記します。
プロダクションアセットとともに証拠を保管する
datasetまたはプロジェクトとともに許可記録を維持します。契約バージョン、許可された使用、ソース録音識別子、および配布に関する制限を含めます。それにより、共有フォルダに単に到着したファイルと、許可された入力を区別しやすくなります。
公開されていることが同意や所有権の証明にはなりません。 また、録音を削除するという約束を、すでにtrained modelからその影響を削除する実証された能力と混同すべきではありません。
歌唱モデルを構築または購入する前に、各関連権利、許可された活動、およびpost-training obligationを網羅する書面による条件を入手してください。
MartLLMは、text、image、video、music、およびspeechモデル向けのAPIです。歌唱関連のproduction workflowを構築している場合は、MartLLMにアクセスして、model listingsを探索し、文書化されたinputsと、score control、audio output、および周辺media tasksに関する要件を比較してください。