Síntese de Voz Cantada: Como Funciona e Onde Falha
Aprenda como a síntese de voz cantada transforma letras e notas em áudio cantado, quais dados de treinamento e vocoders controlam, e onde ainda deixa a desejar.
Você escreveu uma melodia, encaixou a letra nela e carregou um cantor sintético. A primeira reprodução é animadora, até que uma palavra passa rápido demais, uma nota sustentada soa metálica e o refrão soa estranhamente inexpressivo. Esses problemas não têm necessariamente a mesma causa. Entender onde cada um entra na cadeia de sinal torna a correção do vocal muito menos um palpite.
Sumário
- O que é Síntese de Voz Cantada e de Onde Ela Veio
- Como um Sistema de Síntese de Voz Cantada Transforma uma Partitura em Som
- Por Que os Dados de Treinamento Decidem a Qualidade de uma Voz Cantada
- Modelos Acústicos e Vocoders Decidem Onde a Qualidade é Ganhada
- Como Julgar um Sistema de Síntese de Voz Cantada
- Usos Práticos, Limites e Lacunas Culturais
- Confirme os Direitos Antes de Construir ou Comprar um Modelo de Canto
O que é Síntese de Voz Cantada e de Onde Ela Veio
A síntese de voz cantada (SVS) gera áudio cantado a partir de letras, uma sequência de notas com alturas e durações e, em muitos sistemas, uma identidade de cantor selecionada. Digamos que você seja um compositor com uma melodia pronta, mas sem um cantor disponível. Você insere as notas e as palavras para ouvir como a linha vocal se encaixa no seu arranjo.
Isso não é apenas síntese de fala com uma trilha musical de fundo. Uma frase falada precisa de um fraseado crível, mas uma frase cantada também deve seguir as alturas musicais, sustentar as vogais e posicionar as consoantes em torno do ritmo. Uma sílaba que é aceitável em uma conversa pode soar estranha quando esticada em uma nota longa.
De fragmentos gravados a vozes aprendidas
As abordagens iniciais usavam regras e processamento de sinal, seguidas por sistemas que montavam unidades vocais gravadas. Abordagens estatísticas e neurais subsequentemente aprenderam relações entre letras, instruções musicais e saída acústica, em vez de depender apenas da junção de fragmentos.
De acordo com o relato da Yamaha sobre o desenvolvimento do VOCALOID, o projeto começou em fevereiro de 2000 através da colaboração DAISY com a Universitat Pompeu Fabra em Barcelona, e o primeiro produto comercial apareceu em 2004. Os desenvolvedores precisavam de um banco de dados de canto dedicado porque a entrada comum de computador e a tecnologia de fala convencional não conseguiam reproduzir o canto adequadamente.
Cantores virtuais como Hatsune Miku também ajudaram a transformar o canto sintético em um meio criativo centrado em personagens. A voz poderia se tornar parte de uma identidade artística, não apenas uma faixa substituta em uma sessão de gravação.
Distinção útil: Gerar uma performance musical e controlar uma melodia cantada nota por nota não são o mesmo requisito.
Ao navegar por uma lista de modelos de geração de música, verifique os controles de entrada em vez de presumir que toda ferramenta musical aceita uma partitura vocal. Para um sistema de canto utilizável, você precisa entender sua cadeia de sinal, reconhecer seus limites de qualidade e estabelecer como suas vozes podem ser avaliadas e licenciadas.
Como um Sistema de Síntese de Voz Cantada Transforma uma Partitura em Som
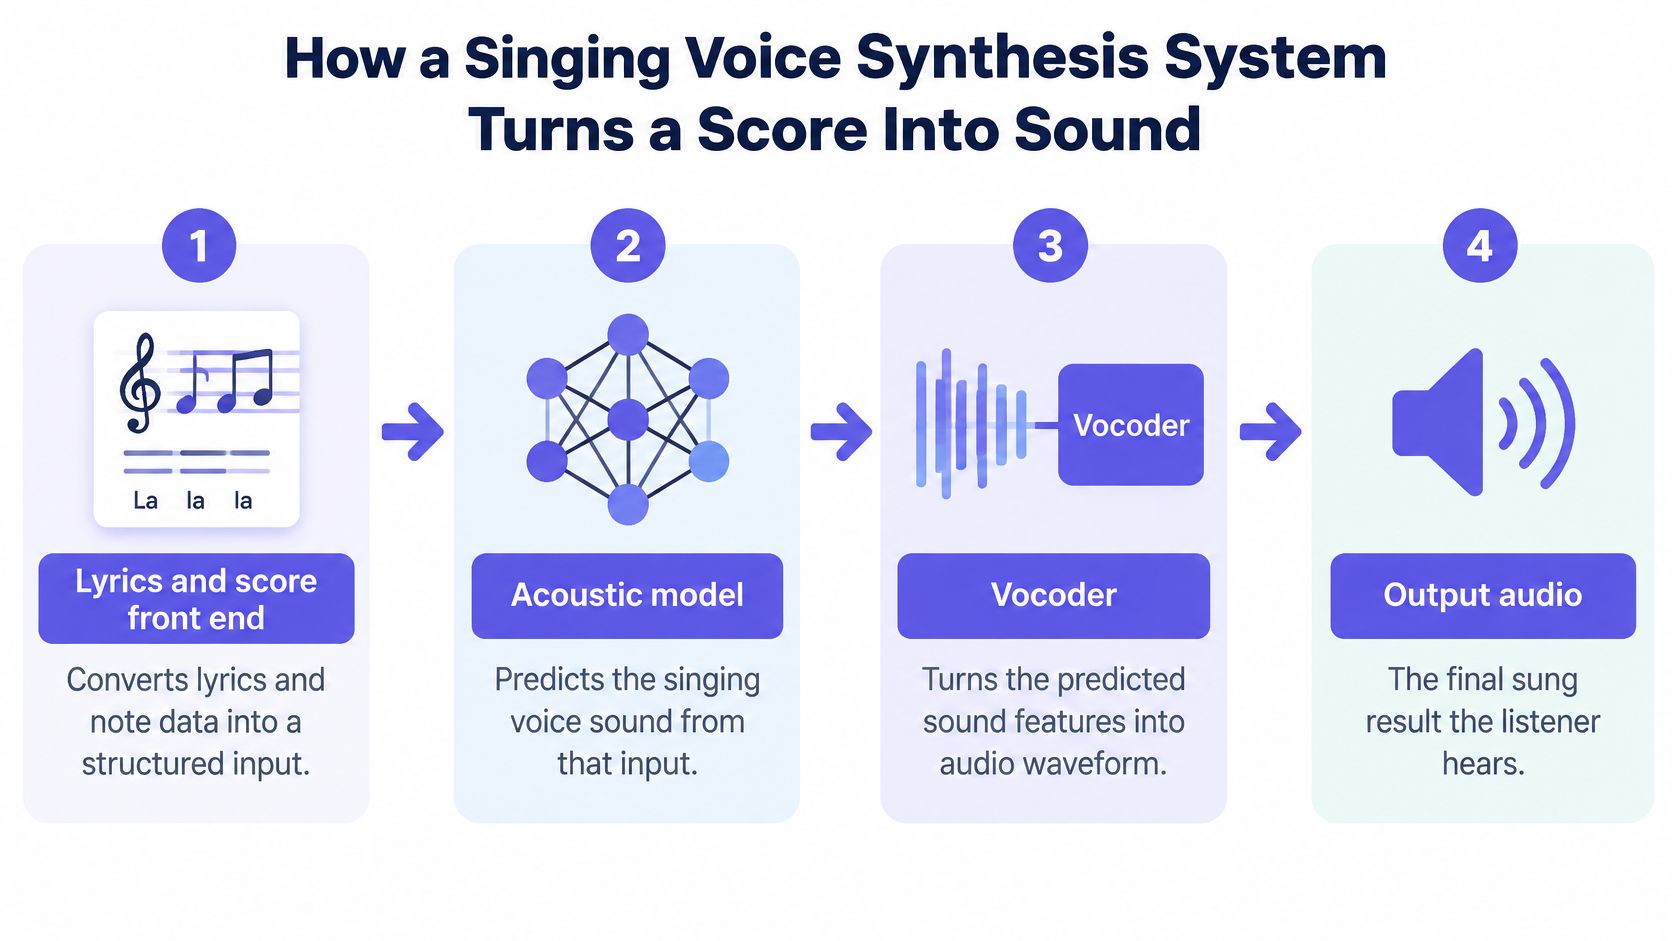
O que entra e o que sai? Em um fluxo de trabalho controlado por partitura, a entrada é um conjunto de instruções musicais. A saída é uma forma de onda que você pode tocar, editar e mixar.
Etapas do pipeline em um sistema de síntese de voz cantada
| Etapa | Entrada | Saída | O Que Controla |
|---|---|---|---|
| Front end de letra e partitura | Letras, altura da nota e duração da nota | Sequência de fonemas com tempo | Qual som é cantado em qual batida |
| Modelo de duração e altura | Fonemas e partitura | Tempo em nível de quadro e curva de altura | Vibrato, ataques de nota e precisão da altura |
| Modelo acústico | Fonemas, tempo, altura e identidade do cantor | Mel-spectrogram | Timbre, forma da vogal e articulação |
| Vocoder | Mel-spectrogram | Forma de onda de áudio | Clareza, soprosidade e artefatos audíveis |
A ilustração mostra o fluxo mais amplo, com decisões de duração e altura incorporadas ao processo de previsão.
Transformando palavras e notas em uma performance
O front end divide as letras em fonemas, os sons individuais da fala dentro das palavras, e os associa às notas. Uma sílaba escrita não é um único som ininterrupto. Em stay, as consoantes iniciais precisam de tratamento diferente da vogal que carrega a altura sustentada.
Se o sistema alocar muito tempo para as consoantes, a vogal pode chegar atrasada. Se ele encurtar a vogal para compensar, a palavra soa apressada, mesmo que a nota termine no tempo certo. Comece com a pronúncia e o posicionamento do fonema quando uma letra parecer ritmicamente errada.
O modelo de duração e altura decide como esses sons se desenrolam ao longo do tempo. A nota especifica uma altura alvo, mas a curva de altura executada pode incluir uma abordagem suave, um centro estável e vibrato em direção ao final. Uma curva perfeitamente plana pode soar rígida; uma transição exagerada pode soar como um scoop não intencional.
Algumas ferramentas aceitam dados de nota explícitos, enquanto outras geram ou inferem uma melodia a partir de entradas menos restritas, incluindo letras. Essa diferença determina se você pode reparar uma nota específica diretamente ou deve solicitar outra performance.
Transformando uma descrição de performance em áudio
O modelo acústico prevê uma representação como um mel-spectrogram, que descreve como a energia sonora é distribuída pela frequência ao longo do tempo. Pense nisso como um mapa mutável do tom da voz, não um arquivo de áudio que você já pode ouvir.
Recursos espectrais mal definidos podem produzir vogais opacas, consoantes borradas ou uma identidade vocal instável. Mas a opacidade por si só não prova que o modelo acústico é o responsável. O gerador de forma de onda final também pode obscurecer detalhes úteis.
O vocoder converte a representação prevista em amostras de som. Zumbidos, granulosidade ou texturas metálicas podem ter origem aqui, especialmente em vogais sustentadas expostas.
Antes de editar, identifique se a ferramenta aceita notas e quais controles afetam a etapa suspeita. Não tente corrigir uma consoante mal posicionada com equalização, ou uma forma de onda áspera reescrevendo uma letra corretamente pronunciada.
Por Que os Dados de Treinamento Decidem a Qualidade de uma Voz Cantada
Gravar canto é apenas parte da construção de um conjunto de dados útil. Desenvolvedores também precisam de letras confiáveis, alinhamento de notas, temporização de fonemas e anotações que distingam a expressão intencional de erros. Sem esse contexto, um modelo pode aprender um evento acústico sem aprender onde ele se encaixa.
A comparação de corpus na pesquisa de conjuntos de dados de canto ilustra a escala limitada e a cobertura de cantores de vários recursos influentes, resumidos abaixo.
Conjuntos de dados de canto por tamanho e cobertura
| Corpus | Cantores | Horas | O Que Abrange |
|---|---|---|---|
| VocalSet | 20 | Cerca de 10.1 | Técnicas vocais, vogais e tons variados, não músicas completas |
| NUS-48E | 12 | Cerca de 2.8 | Corpus pequeno com um grupo limitado de cantores |
| MIR-1K | 19 | Cerca de 2.2 | Corpus pequeno com um grupo limitado de cantores |
| CSD | 1 | Cerca de 4.9 | 100 músicas em dois idiomas de um cantor |
| SingNet | Não especificado no resumo citado | Cerca de 3,000 | Canto 'in-the-wild' e pacotes de samples em vários idiomas e estilos |
O preprint do SingNet relata 2,629 horas de canto 'in-the-wild' e 321 horas de pacotes de samples, totalizando aproximadamente 3,000 horas. Isso representa uma expansão substancial no material disponível, mas o tamanho da coleção não é um certificado de cobertura musical.
A cobertura importa tanto quanto a duração
O foco do VocalSet em técnicas, vogais e tons o torna útil para estudar o comportamento vocal. Isso não o torna intercambiável com um corpus de músicas completas e expressivamente fraseadas. Da mesma forma, uma coleção de um único cantor pode oferecer consistência sem demonstrar que um sistema se generalizará para diferentes identidades vocais.
Overfitting significa que um modelo se torna excessivamente dependente de padrões em seu material de treinamento. Na escuta prática, isso pode significar uma vogal familiar convincente, mas uma pronúncia desconhecida desajeitada, ou um resultado forte em um estilo representado e um resultado pouco convincente em outro lugar.
Para a seleção do modelo, examine:
- Cobertura de cantores: Procure por alcances vocais e identidades documentadas, não apenas uma duração total de gravação.
- Cobertura de idiomas: Verifique se o idioma da sua letra e as convenções de pronúncia estão representados.
- Cobertura musical: Distinga exercícios isolados de frases completas, transições e expressão sustentada.
- Qualidade da anotação: Procure por uma explicação de como as letras e notas foram alinhadas com as gravações.
A pergunta útil não é apenas quanto áudio um desenvolvedor coletou. É o quão fielmente o material documentado corresponde à performance que você precisa. A falta de documentação limita a confiança com que você pode aplicar uma alegação de qualidade além de uma demonstração polida.
Modelos Acústicos e Vocoders Decidem Onde a Qualidade é Conquistada
O gerador de forma de onda pode alterar materialmente a qualidade percebida do canto, mesmo quando o preditor a montante permanece o mesmo. Isso faz do vocoder uma escolha de engenharia, não apenas uma etapa de exportação.
Em um estudo controlado de síntese neural de canto, modelos acústicos baseados em CNN superaram as redes feed-forward correspondentes em testes de naturalidade, e a substituição do vocoder MLSA tradicional por WaveNet melhorou ambas as famílias de modelos. O estudo foi treinado com 55 canções infantis japonesas e 55 canções de J-pop, reservou cinco canções de J-pop, e utilizou pontuações médias de opinião de cinco pontos de 15 ouvintes avaliando frases de teste selecionadas aleatoriamente. Esses resultados apoiam uma comparação controlada, não um ranking universal entre cantores, idiomas ou gêneros.
Separe erros de previsão de erros de renderização
Um modelo acústico pode prever a estrutura vocal errada. Um vocoder pode renderizar uma previsão razoável de forma deficiente. Ambas as falhas podem soar artificiais, mas substituir o mesmo componente não resolverá ambas.
Para um sistema modular, teste o vocoder usando características acústicas extraídas de uma gravação de referência limpa. Este é um teste de ressíntese: você está verificando o quão bem o estágio de forma de onda reconstrói informações que já existem, em vez de pedir ao preditor acústico para inventá-las.
Em seguida, sintetize a partir da partitura. Se a ressíntese de referência for clara, mas a saída gerada pela partitura estiver turva, investigue as características previstas, o alinhamento e o condicionamento de pitch. Se a reconstrução de referência já soar granulada, aborde primeiro o vocoder ou a compatibilidade de características.
Não substitua o modelo inteiro até verificar se o defeito existe antes da geração da forma de onda.
Essa distinção também importa ao avaliar ferramentas de voz adjacentes. Uma listagem de modelos de text-to-speech descreve uma tarefa diferente; a saída de fala inteligível por si só não estabelece a qualidade de notas sustentadas ou o controle da partitura.
Escolha fidelidade e latência para o trabalho real
Vocoders autorregressivos tipo WaveNet geram áudio sequencialmente, o que pode aumentar a latência. Alternativas mais rápidas, incluindo LPCNet, podem ser mais apropriadas quando a reprodução responsiva é importante.
Para renderização offline, você pode aceitar uma espera mais longa para preservar os detalhes vocais. Para composição interativa, você pode preferir uma prévia rápida e reservar uma renderização de maior qualidade para revisão.
Meça tanto o tempo de geração quanto os artefatos que você pode ouvir sob seu fluxo de trabalho pretendido. Uma renderização isolada bonita é menos útil se interromper cada pequena edição de melodia, enquanto uma prévia responsiva não deve ser confundida com a melhor saída final que o sistema pode produzir.
Como Avaliar um Sistema de Síntese de Voz Cantada
Uma voz pode soar natural enquanto desafina, ou seguir as notas com precisão enquanto soa fraca. Nenhuma pontuação de qualidade única descreve a performance completa. Você precisa de julgamentos de ouvintes junto com medições do sinal gerado.
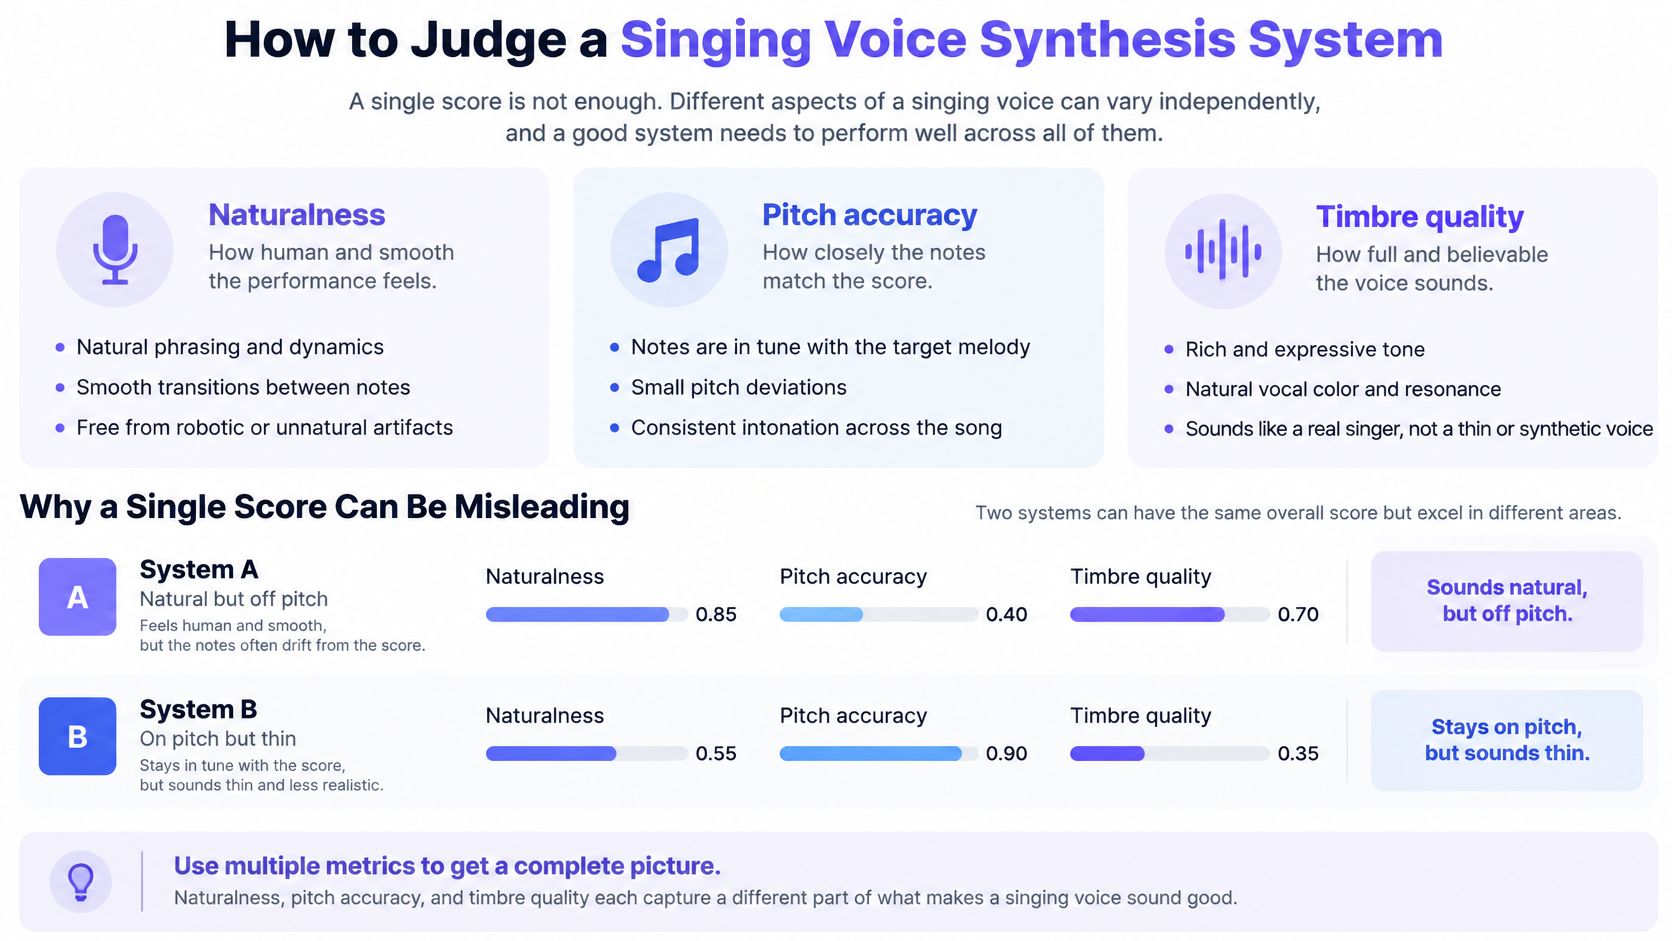
O [artigo WeSinger 2]](https://arxiv.org/html/2207.01886) usa MOS, erro quadrático médio F0 e distorção de mel-espectrograma para examinar aspectos complementares da qualidade do canto. Seu treinamento adversarial condicional multi-cantor melhora o MOS em relação ao sistema WeSinger anterior em Opencpop e Data-L, mas os ganhos comparativos diferem entre os conjuntos de dados, ressaltando a importância das condições do cantor e do corpus.
Métricas para avaliar a qualidade da síntese de voz cantada
| Métrica | O Que Captura | O Que Perde |
|---|---|---|
| MOS | Qualidade percebida geral pelos ouvintes | Pode ocultar desvios de afinação e detalhes específicos do cantor |
| F0 RMSE | Erro de afinação, entonação e ajuste | Respiração, pronúncia e timbre |
| MSD | Descasamento espectral ligado ao timbre e articulação | Se uma frase soa expressiva ou no estilo |
Leia as medições em conjunto
MOS, ou mean opinion score, resume as avaliações dos ouvintes. É útil para perguntar se as pessoas preferem o resultado geral, mas a interpretação depende do que ouviram e do que lhes foi pedido para julgar.
F0 RMSE mede o erro na frequência fundamental, a quantidade acústica associada à afinação percebida. Ajuda a revelar problemas de afinação, mas não estabelece que as palavras são inteligíveis ou que o tom vocal é crível.
MSD compara representações espectrais. Pode expor diferenças relacionadas à articulação e ao timbre, mas igualar um espectrograma de referência não é o mesmo que fazer uma escolha artística convincente.
Verificação de audição: Audicione o vocal sozinho antes de julgá-lo dentro de uma mixagem densa. O acompanhamento pode tornar consoantes fracas e finais de notas instáveis mais difíceis de notar.
Crie um conjunto de avaliação contendo músicas desconhecidas e, onde o sistema as suporta, cantores reservados. Inclua vogais sustentadas, letras com muitas consoantes, mudanças de registro e frases que exigem um tempo expressivo deliberado.
Relate as métricas em conjunto, depois ouça especificamente a respiração, pronúncia e identidade vocal. Se um fornecedor oferece apenas uma pontuação de naturalidade principal, trate-a como evidência sobre aquele teste de audição, não como prova de que sua letra, cantor e arranjo funcionarão igualmente bem.
Usos Práticos, Limites e Lacunas Culturais
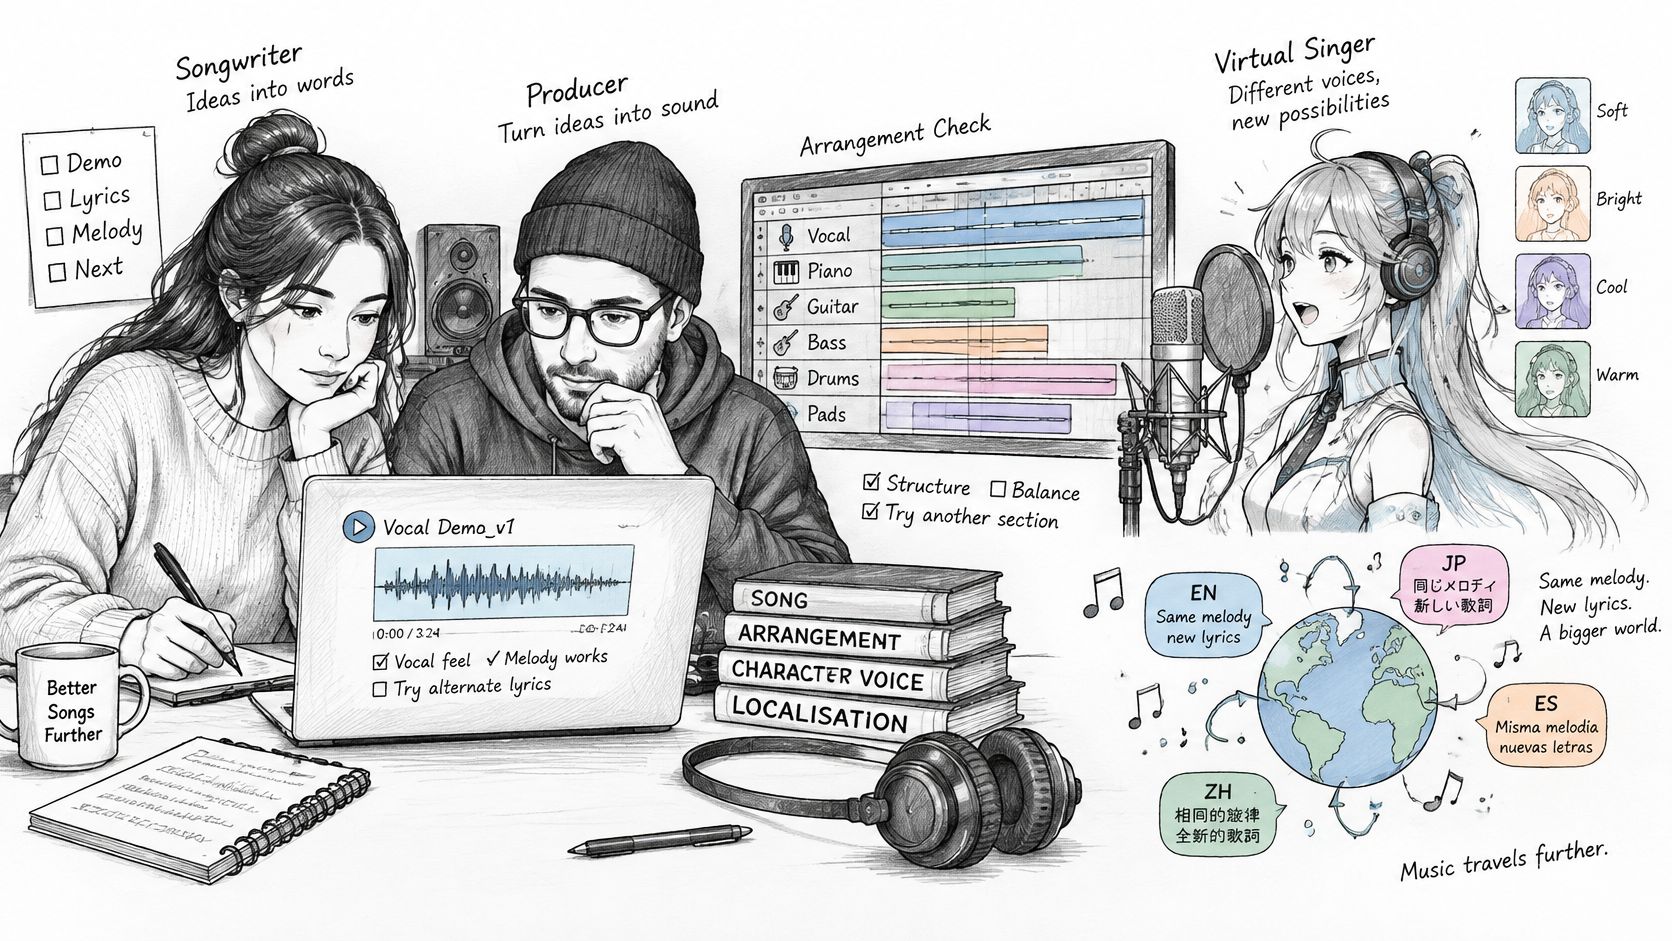
Um compositor pode usar canto sintético para verificar se um refrão é cantável antes de agendar uma sessão. Um produtor pode testar uma harmonia, enquanto uma equipe de jogo pode verificar como a música de um personagem se encaixa em uma cena. Estes são usos práticos porque a performance gerada ajuda as pessoas a tomar uma decisão de produção concreta.
Lançamentos centrados em personagens e protótipos de animação também podem usar uma estética vocal deliberadamente sintética. Para prototipagem audiovisual, um guia para criar um videoclipe de IA pode ajudar a conectar o fluxo de trabalho de áudio à produção visual, mas o vocal ainda precisa de sua própria revisão musical.
Teste a expressão, não apenas as notas corretas
A localização é um exemplo útil de onde uma tarefa aparentemente simples se torna exigente. Manter a melodia ao mudar de idioma significa encaixar novas sílabas, padrões de estresse e consoantes em uma frase existente. Uma tradução literal pode ser inadequada como letra cantada.
A expressão culturalmente específica adiciona outra camada. O capítulo sobre canto clássico indiano descreve a ornamentação em relação à nota particular, raga, cantor e contexto musical, detalhes que as medições convencionais de afinação e inteligibilidade podem perder.
Use testes direcionados em vez de perguntar apenas se o resultado soa humano:
- Ornamentação: Peça a um músico familiarizado com a tradição para julgar o movimento entre e ao redor das notas.
- Troca de código: Coloque uma mudança de idioma dentro de uma frase e verifique o sotaque, o estresse e a continuidade da identidade vocal.
- Palavras raras: Teste nomes e vocabulário lírico incomum, e então peça a um falante fluente para avaliar a pronúncia.
- Fraseado: Compare onde o cantor gerado respira, enfatiza uma palavra ou libera um final sustentado.
Verifique a origem separadamente da qualidade
Um vocal convincente não estabelece quem o executou. O relato do National Institute of Justice sobre o desafio inaugural de detecção de deepfake de voz cantada relata 47 equipes participantes e uma taxa de erro igual de 1.65% da equipe principal no cenário do desafio.
Esse resultado demonstra o desempenho medido do detector sob condições particulares, não a autenticação garantida de um lançamento arbitrário. Trate a detecção como uma verificação ao lado de registros de proveniência, arquivos de origem e autorização documentada.
O canto sintético é particularmente útil para rascunhos, protótipos e vozes de personagens intencionais. Um vocal comercial final, especialmente em um grande lançamento, precisa de revisão humana para expressão musical, precisão da linguagem, identidade e proveniência, em vez de aprovação baseada apenas em uma demo com som limpo.
Confirme os Direitos Antes de Construir ou Comprar um Modelo de Canto
Quem autorizou a voz antes que ela seja treinada, clonada ou lançada? Uma gravação vocal pode envolver um intérprete, um proprietário da gravação, um letrista e um compositor. A permissão referente a uma contribuição não resolve automaticamente as outras.
O artigo da AI & Society sobre governança de dados de canto alerta que uma licença Creative Commons padrão pode não proteger adequadamente os contribuidores de dados de canto, porque as gravações podem conter tanto a voz de um intérprete quanto uma música protegida por direitos autorais. Também distingue as regras de uso justo dos EUA da exceção de mineração de texto e dados da UE, em vez de tratá-las como permissões intercambiáveis.
Coloque os usos permitidos por escrito
Use uma lista de verificação de direitos antes de transferir gravações ou integrar um modelo:
- Identifique os direitos relevantes. Documente as permissões referentes às gravações do cantor, letras, composição, imagem e lançamento comercial pretendido. Registre quem pode autorizar cada uso, em vez de presumir que a pessoa que fornece o arquivo controla tudo.
- Especifique as atividades do modelo. Declare se o acordo permite treinamento, fine-tuning, clonagem de voz, redistribuição e uso comercial posterior. Uma licença para publicar uma faixa de áudio não deve se tornar uma permissão para construir um modelo de voz reutilizável.
- Leia os termos da licença. Não confie apenas em um rótulo Creative Commons. Verifique se os termos abordam a contribuição do intérprete e a música subjacente.
- Verifique a jurisdição aplicável. Peça a um advogado qualificado para avaliar as regras relevantes para as gravações, contribuidores e implantação. Não transplante uma exceção de outro sistema legal para o seu acordo.
- Planeje o que acontece após o treinamento. Defina procedimentos de revogação, remoção do modelo, atribuição e compartilhamento de receita. Especifique quem lida com as solicitações e quais recursos estão disponíveis técnica e contratualmente.
Mantenha a evidência com os ativos de produção
Mantenha um registro de permissões junto com o conjunto de dados ou projeto. Inclua a versão do acordo, usos permitidos, identificadores de gravação de origem e quaisquer restrições de distribuição. Isso facilita a distinção entre uma entrada autorizada e um arquivo que simplesmente chegou em uma pasta compartilhada.
A disponibilidade pública não é prova de consentimento ou propriedade. Nem uma promessa de remover uma gravação deve ser confundida com a capacidade demonstrada de remover sua influência de um modelo já treinado.
Antes de construir ou comprar um modelo de canto, obtenha termos por escrito cobrindo cada direito relevante, atividade permitida e obrigação pós-treinamento.
MartLLM é uma API para modelos de texto, imagem, vídeo, música e fala. Se você está construindo um fluxo de trabalho de produção relacionado a canto, visite MartLLM para explorar as listagens de modelos e comparar suas entradas documentadas com seus requisitos para controle de partitura, saída de áudio e tarefas de mídia circundantes.